목소리 복제·받아쓰기 한 곳에, 오픈소스 Voicebox
음성 합성(TTS)과 받아쓰기(STT)를 한 앱에 모은 로컬 우선 오픈소스 스튜디오, Voicebox를 소개해요. 7개 TTS 엔진, 목소리 클로닝, 전역 받아쓰기 단축키, 에이전트 음성 출력(MCP)까지 로컬에서 처리하므로 데이터가 내 기기 밖으로 나가지 않아요.
음성 AI의 두 갈래를 한 곳에
음성 AI 도구는 크게 둘로 나뉘던 시절이 있었어요. 목소리를 만들고 합성하는 데는 ElevenLabs가, 받아쓰기 입력 쪽은 WisprFlow가 사실상 표준이었죠. 문제는 이 둘이 서로 반대 방향을 맡는다는 거예요.
출력(합성)과 입력(인식)을 따로 쓰려면 앱을 둘 두고, 둘 다 클라우드 기반이라 녹음 데이터가 내 기기 밖으로 나가요. Voicebox(by jamiepine)는 이 두 갈래를 하나의 로컬 앱에서 모두 해결한 오픈소스 프로젝트예요. 스스로를 "올인원 AI 보이스 스튜디오"라고 부르며, MIT 라이선스 아래 GitHub에서 5만 4400여 개의 스타를 받으며 급부상했어요.
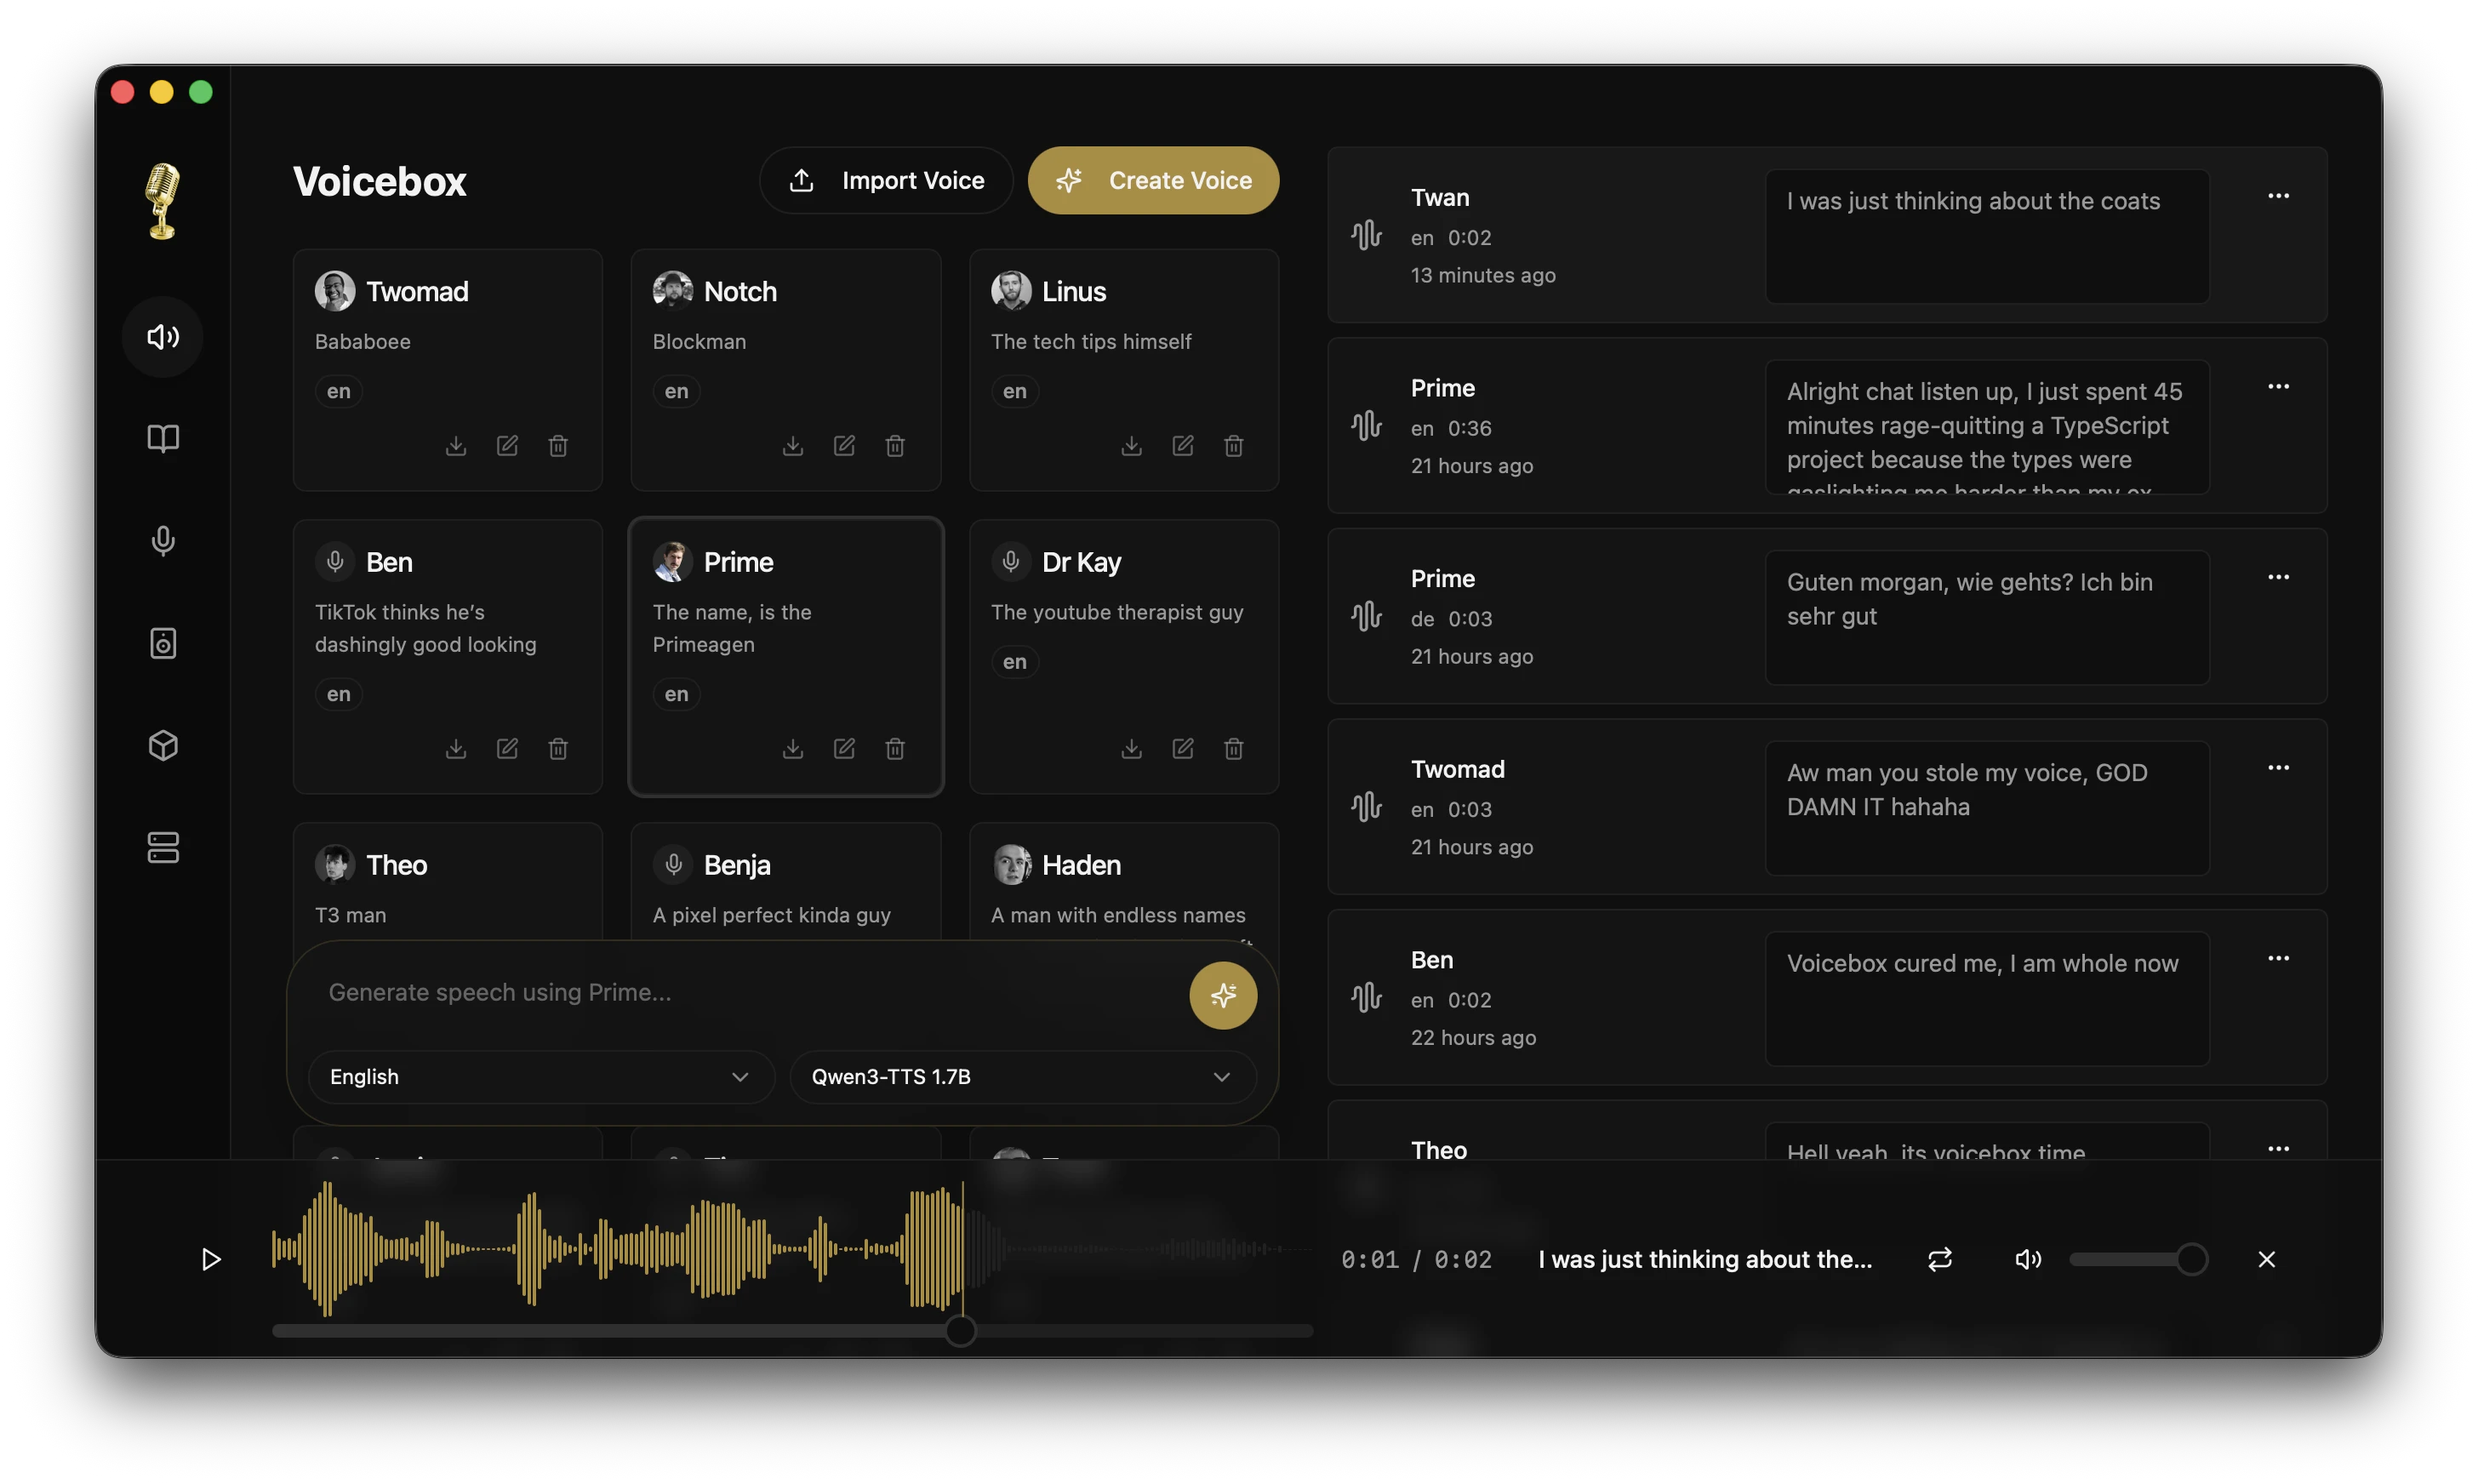 출처: jamiepine/voicebox GitHub 저장소
로컬에서 돈다는 게 무슨 뜻일까
백엔드는 Python FastAPI로, 데스크톱 앱은 Rust 기반 Tauri로 만들어졌어요. Electron 대신 Tauri를 써서 메모리 사용을 줄인 게 특징이에요. 모든 추론(TTS·STT·로컬 LLM)은 기기에서 일어나고, 추론 백엔드는 환경별로 자동 골라져요.
| 환경 | 추론 백엔드 | 비고 |
|---|---|---|
| macOS(Apple Silicon) | MLX(Metal) | Neural Engine으로 4~5배 가속 |
| Windows(NVIDIA) | PyTorch CUDA | 앱 안에서 CUDA 바이너리 자동 설치 |
| Linux(AMD) | PyTorch ROCm | HSA 오버라이드 설정 자동화 |
| Windows(모든 GPU) | DirectML | 범용 GPU 지원 |
| Intel Arc | IPEX/XPU | 인텔 개별 GPU 가속 |
| 어디든 | CPU | 느리지만 어디서든 동작 |
클라우드 서비스를 쓰면 내 목소리 샘플이 서버로 올라가지만, 여기선 전 구간이 로컬이라 프라이버시 걱정이 줄어요. 음성 프로필·녹음·캡처 모두 내 데이터 폴더에만 저장돼요.
일곱 개 TTS 엔진, 상황에 맞게 고르기
Voicebox의 핵심은 멀티 엔진 설계예요. 하나의 큰 모델에 얽매이지 않고 목적별로 강한 엔진을 골라 쓸 수 있어요.
| 엔진 | 언어 | 특징 |
|---|---|---|
| Qwen3-TTS (0.6B/1.7B) | 10 | 다국어 클로닝, "천천히 말해", "속삭여" 식 지시 |
| Qwen CustomVoice | 10 | 9개 사전 목소리, 자연어 발화 제어 |
| LuxTTS | 영어 | 가벼움(~1GB VRAM), 48kHz, CPU 실시간 150배 |
| Chatterbox Multilingual | 23 | 가장 넓은 언어 커버리지 |
| Chatterbox Turbo | 영어 | 350M 파라미터, [laugh] 같은 감정 태그 |
| TADA (1B/3B) | 10 | HumeAI, 700초 이상 연속 발화 |
| Kokoro | 8 | 82M 초경량, 50개 사전 목소리, 빠른 CPU |
오디오북처럼 긴 대본은 길이 제한 없이 자동 분할·크로스페이드 되고, 감정 표현이 필요한 캐릭터 대사는 Chatterbox Turbo로 [laugh] 같은 태그를 넣으면 웃음소리가 합성돼요. 이후 8종의 후처리 이펙트(피치·리버브·딜레이·컴프레서 등)를 한 번 더 적용할 수 있고, 재사용 가능한 프리셋으로 저장해요.
받아쓰기와 에이전트 음성까지
이 프로젝트가 주목받는 진짜 이유는 출력만이 아니라 입력과 에이전트 연결까지 다룬다는 점이에요.
전역 받아쓰기 — 핫키를 누른 채 말하면 Whisper가 받아쓰고, macOS에선 포커스된 텍스트 필드에 자동 붙여넣기가 돼요. "어" 같은 군더더기는 선택적으로 로컬 LLM이 정리해 줘요.
에이전트 음성 출력 — MCP(Model Context Protocol) 서버를 내장해서, Claude Code·Cursor·Windsurf 같은 에이전트가 voicebox.speak 한 번의 도구 호출로 내가 클로닝한 목소리로 말하게 할 수 있어요.
// MCP를 지원하는 어떤 에이전트에서든
await voicebox.speak({
  text: "배포 완료.",
  profile: "Morgan",   // 클로닝한 음성 프로필
});
핵심은 음성 프로필에 성격(personality)을 붙일 수 있다는 거예요. 로컬 Qwen3(0.6B/1.7B/4B)가 그 성격으로 문장을 다시 써 준 뒤 TTS로 합성해요.
처음 문구를 뽑는 Compose, 입력을 캐릭터 관점으로 고쳐 주는 Rewrite 모드가 있고, 에이전트는 personality: true 인자로 같은 파이프라인을 그대로 호출할 수 있어요.
REST API와 개발자 경험
같은 기능은 REST API로도 노출돼요. 기본 포트는 17493이고, 합성(/generate), 에이전트 음성(/speak), 인식(/transcribe), 프로필 목록(/profiles) 같은 엔드포인트가 있으니 자체 앱이나 스크립트에 음성 입출력을 붙이기 쉬워요.
# 음성 합성
curl -X POST http://127.0.0.1:17493/generate \
  -H "Content-Type: application/json" \
  -d '{"text": "안녕하세요", "profile_id": "abc123", "language": "ko"}'
언어는 23개를 지원하고 목소리 클로닝은 몇 초 분량의 샘플이면 충분해요. 최신 0.5.0(Capture) 릴리스에서 받아쓰기·MCP·성격 기능이 함께 들어왔고, 로드맵엔 Windows/Linux 자동 붙여넣기, 스트리밍 받아쓰기, 음성 대 음성 엔드투엔드 모델 등이 잡혀 있어요.
누구에게 유용할까
- 클로닝을 시험해 보려는 개인 — 몇 초 샘플로 내 목소리 합성을 무료로, 로컬에서 확인해볼 수 있어요.
- 에이전트 개발자 — MCP로 에이전트가 말하게 해서 음성 인터랙션을 빠르게 붙일 수 있어요.
- 프라이버시 중시 사용자 — 음성 데이터가 외부로 나가지 않는 설계라 보안에 민감한 환경에 적합해요.
다만 한계도 있어요. 23개 언어 중 한국어 품질은 엔진에 따라 편차가 있고, Linux는 아직 사전 빌드 바이너리가 없어 소스에서 빌드해야 해요. 여러 모델을 동시에 로드하면 GPU 메모리 부담도 커져요.
그 대신 합성과 받아쓰기, 에이전트 음성을 오픈소스로 한곳에서 다루는 건 흔치 않은 선택이에요. 공식 사이트는 voicebox.sh에서 확인할 수 있어요.
참고 링크
Related posts
 Open Source & Dev Tools
네이티브 macOS 런처 Tinycast, 램 100MB 오픈소스
macOS 런처 시장에서 전통의 Raycast·Alfred는 Electron이라 무겁다는 지적이 많았어요. Tinycast는 SwiftUI+AppKit 기반, 제로 서드파티 의존성, 램 100MB 상한을 내세운 AGPL-3.0 오픈소스 런처예요. 무거운 확장 생태계 없이 가볍게, 그리고 Raycast 확장까지 네이티브로 돌려주는 게 특징이에요.
왓츠앱 영업을 AI가 대신하는 오픈소스 세일즈 CRM Deskcomm
셀프호스팅 오픈소스 AI 세일즈 CRM Deskcomm을 분석해요. 왓츠앱으로 상담·판매하는 비즈니스를 겨냥해 AI 에이전트가 스스로 CRM을 조종하고, MIT 라이선스로 데이터를 내 서버에 두는 점, 멀티 테넌트·LGPD 설계, 설치와 한계를 다뤄요.
 Open Source & Dev Tools
오픈소스로 ERP·HRM·프로젝트까지, Ever Gauzy
불가리아 개발사 Ever가 만든 오픈소스 경영 관리 플랫폼 Ever Gauzy를 분석해요. ERP·CRM·HRM·ATS에 타임트래킹까지 하나의 제품으로 묶어 에이전시·스튜디오에 특화됐고, AGPL-3.0 기반으로 셀프호스팅이 자유롭지만 SaaS 제공 시 카피레프트 의무가 생겨요.
Curated, fact-checked, and edited by a single operator before publishing.