블로그
직접 돌린 실험, 운영하며 고친 문제, 원문과 대조한 논문·도구 노트를 모았어요. 모든 글에 근거 출처를 링크로 붙이고, 수치는 원문이나 직접 측정한 값만 써요.
직접 돌린 실험부터 논문 노트까지 공개 글을 모두 보여줘요. 카테고리를 고르면 그 카테고리가 무엇을 다루는지 여기에 보여요.
코드 리뷰 비용 45배 줄인 Jev, 정확도는 어떤가
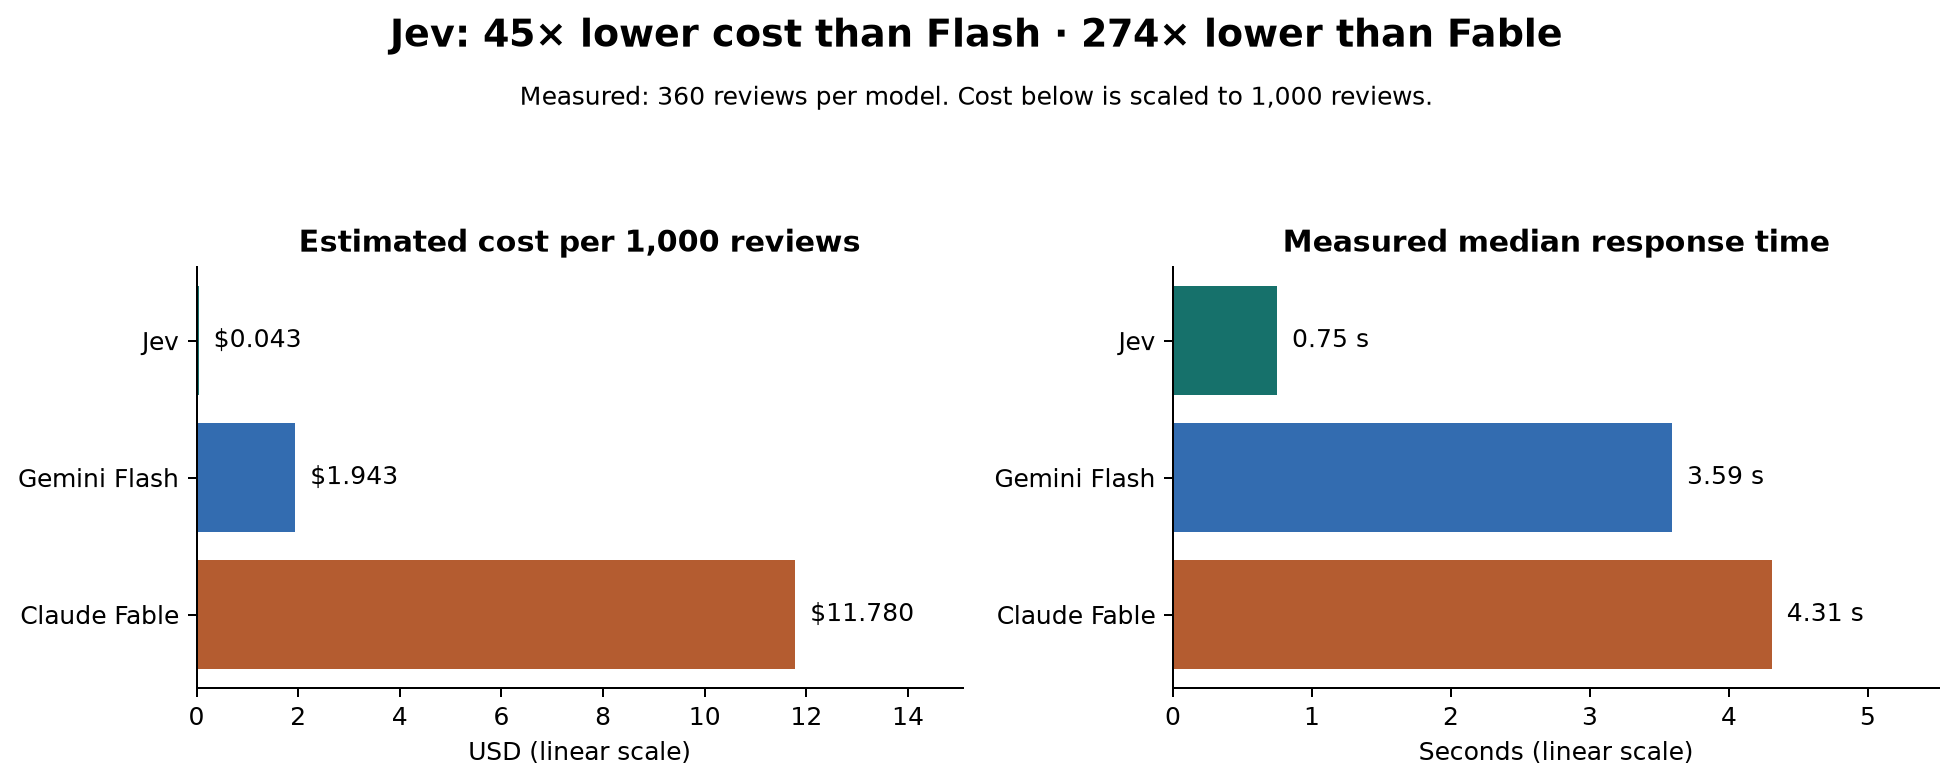
TypeSafe의 System One 모델 Jev를 Gemini 3.8 Flash·Claude Fable 5.1과 같은 Python 코드 리뷰 과업에 넣고 비용·속도·정확도·일관성을 비교한 벤치마크예요. Jev가 비용을 약 45~275배 아끼고 응답 중앙값도 약 5~6배 빠르지만, 정확도 98%로 소폭 낮아요. 다만 직접 만든 예제로 잰 결과라 읽는 법이 중요해요.
Gemini가 후임 모델을 9달러에 스스로 훈련했다
개발자가 취미용 스크래퍼의 댓글 단위 AI 결제를 줄이려고, Gemini에 라벨을 한 번만 맡기고 오픈소스 NER 모델 GLiNER로 이식했다. 총비용은 라벨 9달러+GPU 2.5달러이고 결과는 검증셋 0.83 F1. 작은 파인튜닝 일감의 실제 비용과 삽질을 솔직하게 공개한 글이다.
에이전트에 기억보다 '실행 검증'이 먼저인 이유
듀얼프로세스 에이전트에 기억(AMM)과 자기 반성(SRM) 모듈을 붙이고 ScienceWorld에서 소거 실험한 arXiv 논문을 풀이했어요. 핵심은 기억이 아니라 실행 시점 제어가 성능 병목이며, 무한 반성이 오히려 해롭다는 점입니다.
로깅 데이터만으로는 못 잰다, OPE의 지수적 어려움
오프 정책 평가(OPE)가 부분 관측 환경 아래에서, 겉보기엔 건강한 로깅 데이터로도 지수적으로 어려워질 수 있음을 이론·실험으로 증명한 2026년 9월 arXiv 논문을 정리했어요. 필요 샘플이 (3/2)^H로 폭발하는 하한과 실무 시사점을 담았어요.
DeepSeek V4.1 Flash, 해킹 벤치마크 만점 비결
DeepSeek V4.1 Flash가 Enclave가 운영하는 AI 해킹 벤치마크에서 11/11을 기록했어요. 11번 중 5번은 설계자가 기대하지 않은 경로로 성공해서 채점이 보강됐어요. 벤치마크 운영사가 직접 발표한 결과라는 점과 순위가 시한성이라는 점을 함께 짚어요.
이질 비동기 분산 최적화, 왜 개선이 불가능한가
워커마다 다른 데이터 분포를 쓰는 이종 비동기 분산 학습은 동종 설정보다 훨씬 느린 시간복잡도에 묶여요. 2026년 9월 arXiv 논문은 이 격차가 흔한 함수 유사성 가정으론 수학적으로 좁힐 수 없음을 증명하고, 강한 보간과 국소 Polyak-Łojasiewicz 조건을 함께 요구할 때만 동종 수준의 수렴 보장이 가능함을 보여줘요.
무선 기기 바꿔치기 탐지 FreqSpaNet, AUROC 96%
하드웨어를 몰래 교체해도 논리적 정체성은 유지되는 무선 기기의 위협을 다룬 연구예요. FreqSpaNet은 주파수·방향 정보를 각각 학습해 평균 AUROC 96.31%를 기록했지만, 실험은 한 곳·한 수신기 조건이라 일반화 범위를 함께 짚어요.
ENCP: 길찾기 AI에 확률 보증이 있는 불확실성을 더하다
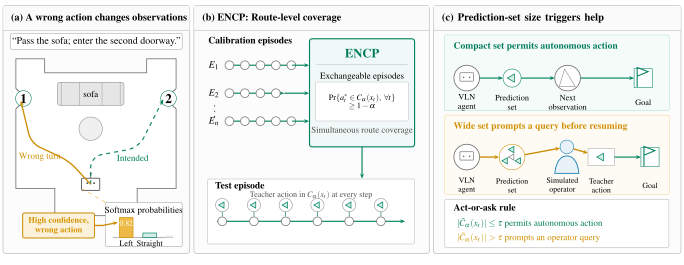
길찾기 AI(VLN)는 한 걸음 잘못 디디면 뒤로 계속 틀려가는 오류 누적에 취약한데, 새 논문 ENCP는 여기에 확률 보증이 있는 불확실성 추정을 제안해요. 에피소드마다 최댓값 하나만 캘리브레이션해 경로 전체의 커버리지를 보장했고, 실험에서 스텝 커버리지 목표를 모두 달성했으며, 예측 집합 크기로 사람에게 도움을 요청할 시점을 정합니다.
Docker 빌드 이력에 남은 GitHub 토큰, 25분 만에 관리자 권한
보안 도구 회사 Strix가 자기 블로그에 공개한 사례예요. 공개 Harbor 레지스트리의 이미지에서 Docker 빌드 이력에 남은 GitHub 토큰을 찾았고, 그 토큰은 3년 넘게 유효하며 관리자 권한을 가졌다고 해요. 단일 출처라는 점을 짚고, 노출 메커니즘과 점검 방법을 따로 풀어요.
수학 연구를 에이전트로, 구글 스텔라 콜로세움 분석
증명을 쓰기 전에 여러 전략을 탐색하고 준비 게이트를 거쳐 분해하는 수학·이론컴퓨터과학용 멀티에이전트 하네스 논문이에요. 논문은 TCS-Bench에서 71.0%, Codeforces 222문제 중 218개를 보고하지만, 모든 수치가 논문 한 편에서 나온 값이라는 점과 비교 조건을 함께 짚어요.
AI 코딩 에이전트, 세션·PC를 넘어 협업하는 새 프로토콜 'agent-comms'
세션을 닫으면 기억이 리셋되는 AI 코딩 에이전트의 고질병에 오픈소스 'agent-comms'는 작업 맥락 캡슐과 웹소켓 릴레이로 답해요. 신생 프로젝트라 검증된 부분과 아직 비어 있는 부분을 나눠서 짚어요.
오픈소스 YuE2, Suno와 견주는 하얀 상자 음악 생성
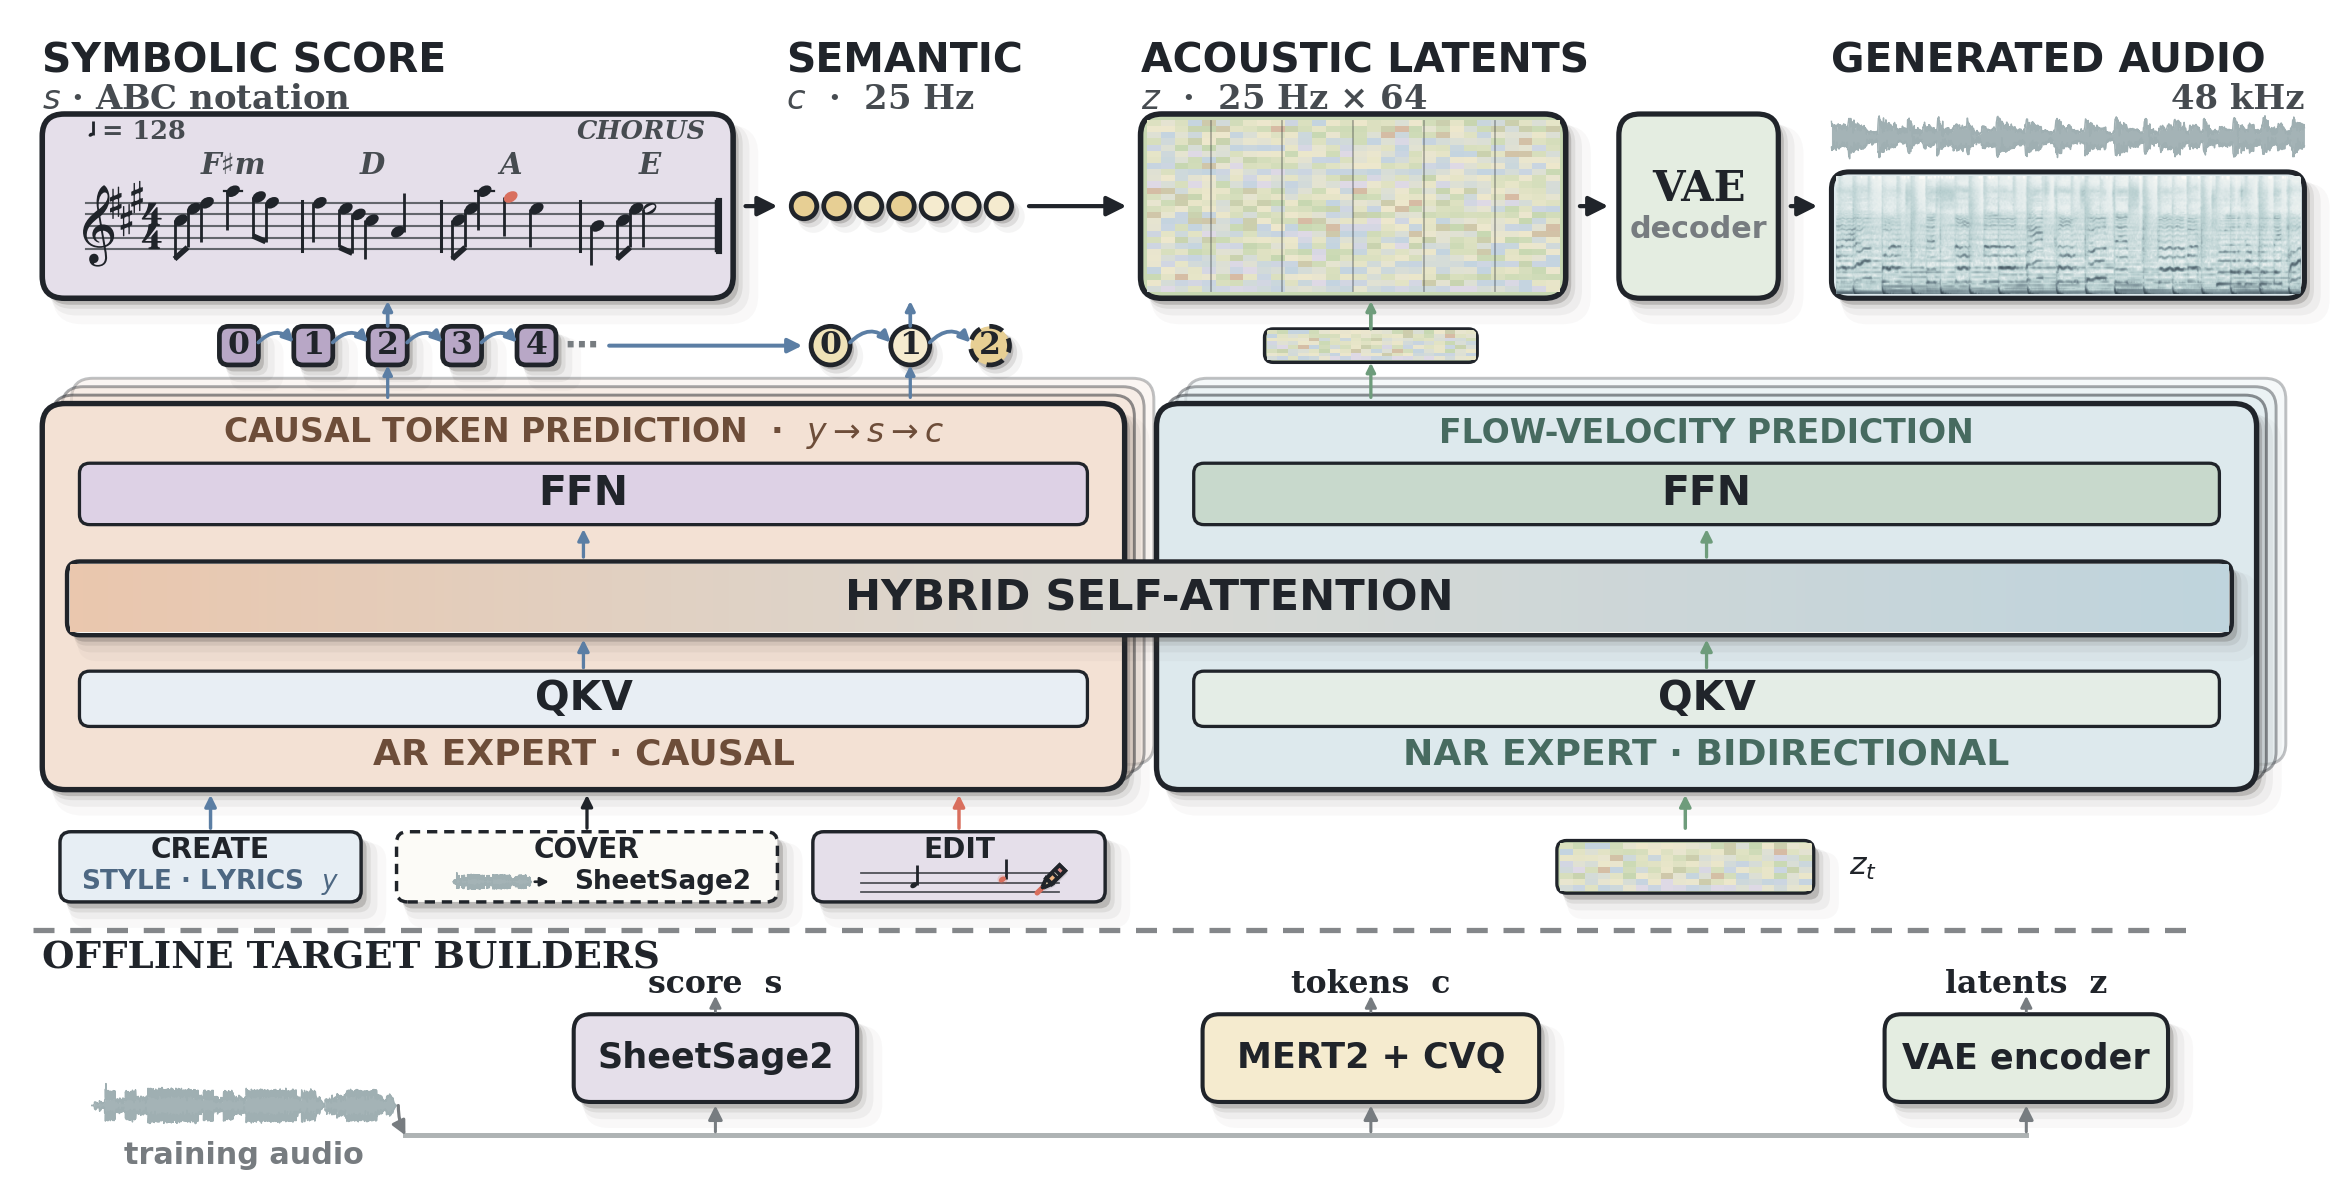
오픈소스 YuE2가 상징 계획(symbolic planning) 방식으로 만든 멜로디·코드 악보를 편집할 수 있게 했어요. WildSongBench에서 Suno와 경쟁하는 스코어를 내면서도, 무게 중심은 코드가 Apache 2.0, 모델은 CC BY-NC 4.0으로 열려 있어요.
알리바바의 AI 코드리뷰 도구, 오픈소스로 풀림
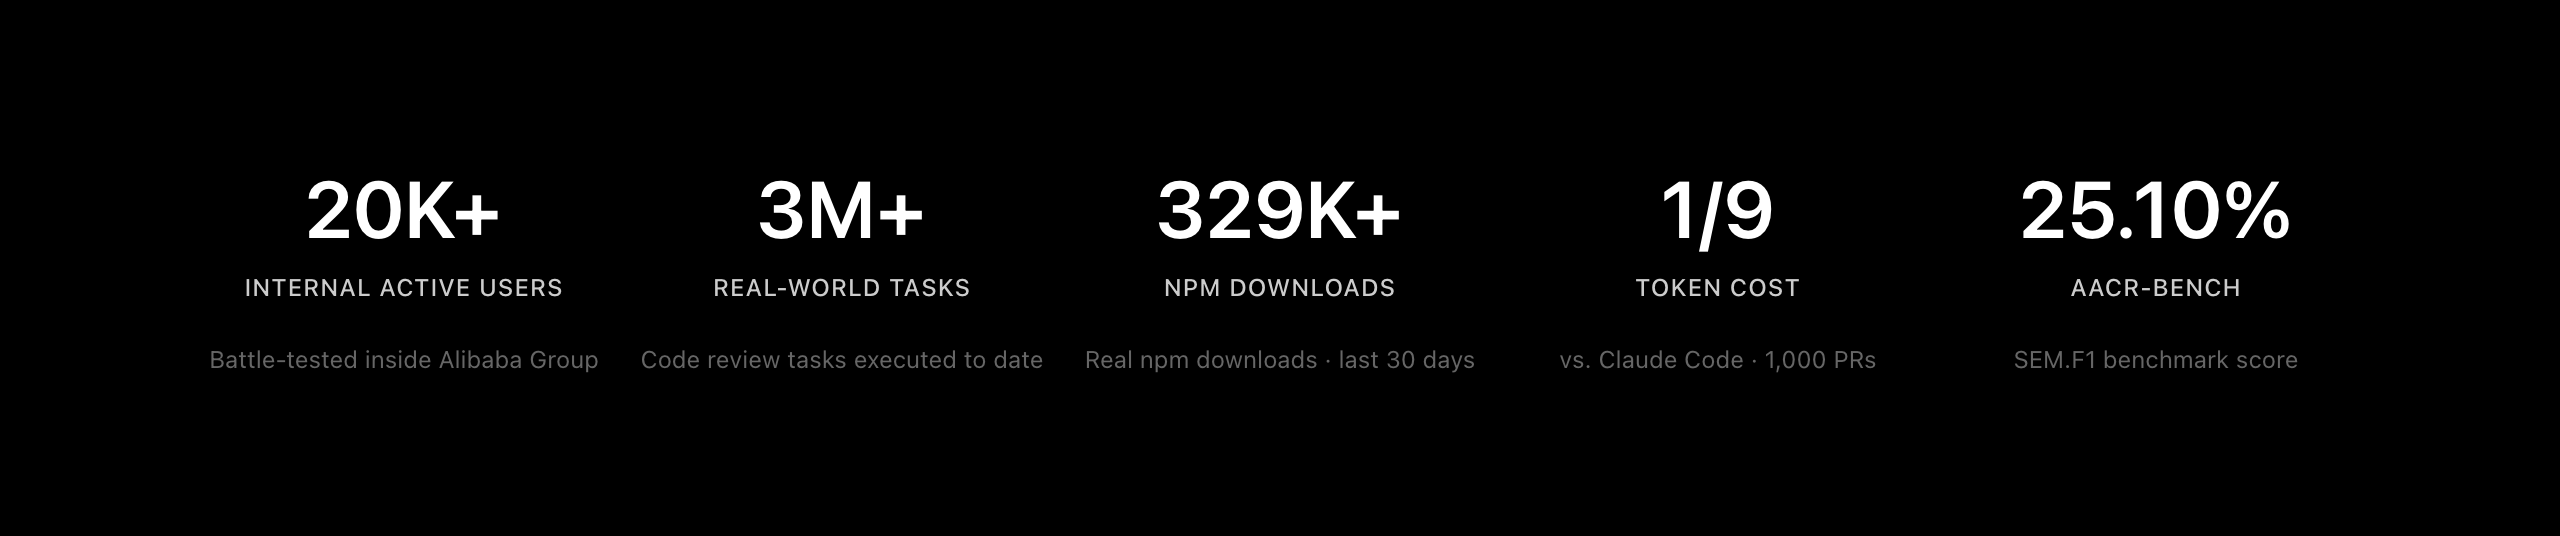
알리바바 내부에서 쓰던 AI 코드리뷰 CLI가 오픈소스로 나왔어요. 결정적 파이프라인과 에이전트를 섞은 구조이고, 토큰을 약 9분의 1로 줄였다는 결과는 개발팀이 직접 공개한 벤치마크라는 점까지 같이 짚어요.
MAxBench: 동물 개념은 직선이 아니라 아핀 부분공간이에요
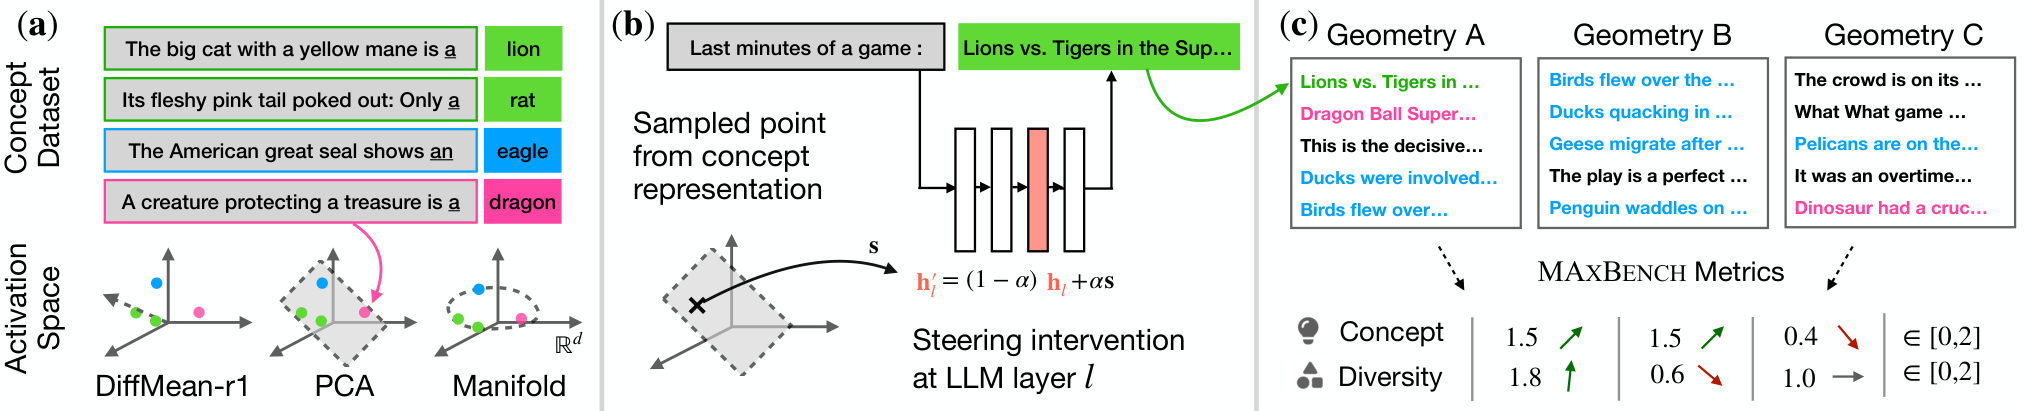
MAxBench는 '동물·국가·식물'처럼 여러 하위 범주를 가진 다항 개념을 LLM에서 어떻게 복구·조종할지 평가하는 벤치마크예요. 10개 기법을 4개 모델로 비교한 결과 아핀 부분공간이 단일 방향보다 잘 작동했고, 그 장점은 기저보다 개념 중심 오프셋에서 크게 나왔어요.
예측 확률 신뢰도를 순위로 재는 새 지표 rankECE
모델이 말한 확률이 실제와 얼마나 일치하는지(캘리브레이션 오차)를 재는 ECE는 유한 표본에서 정확한 추정이 불가능하다는 난제가 있어요. 이 논문은 조정 파라미터 없이 이웃 순위 비교만으로 ECE의 하한에 가까운 값을 얻는 rankECE를 내놓고, 기존 빈(bin) 근사보다 정확하다는 걸 이론·실험으로 보여줘요. 어떤 조건에서 이 값이 ECE를 낮게 잡을 수 있는지도 함께 짚어요.
LLM 게이트웨이 대신 호출 프로세스에 복원력을 넣는 vernLLM
Show HN에 오른 vernLLM은 게이트웨이를 거치지 않고 호출 프로세스 안에 rate-limit, 회로차단기, 폴백을 넣는 TypeScript 라이브러리예요. 게이트웨이와 비교해 무엇을 얻고 무엇을 직접 떠안는지, 여러 인스턴스로 돌릴 때 어떤 문제가 생기는지 짚어요.
동시 확률 게임을 PAC로 학습하기, 균형을 찾거나 없음을 증명하는 알고리즘
천이 확률이 불확실한 동시 확률 게임에서 근사 Nash 균형을 찾거나 균형이 없음을 인증하는 PAC 학습 알고리즘을 읽어요. 저자들은 이 설정의 첫 PAC 프레임워크라고 주장하고, 6개 소규모 벤치마크에서 이론과 맞는 경향을 보였어요. 대신 중앙 집중 학습과 알려진 천이 지원이 전제예요.
자연어로 함수를 컴파일한다? Compile by Training
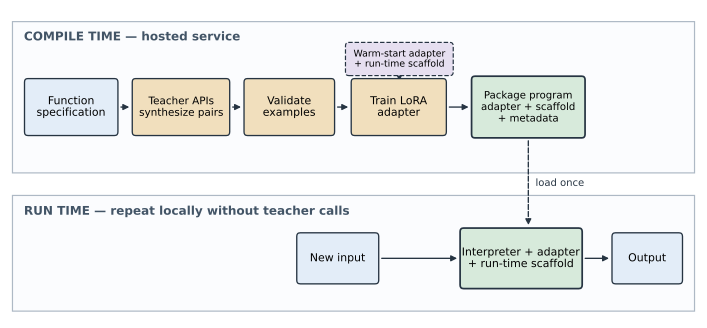
매 입력마다 대형 모델 API를 호출하는 대신, 한 번의 컴파일로 사양을 로컬 신경 함수로 바꾸는 'Compile by Training'을 소개해요. 벤치마크에서 의미 정확도 22.4%에서 83.6%로 올리고, 컴파일 후에는 교사 모델 없이도 동작해요.
AI 에이전트에 '덜 쓰기'를 가르치는 오픈소스, ponytail
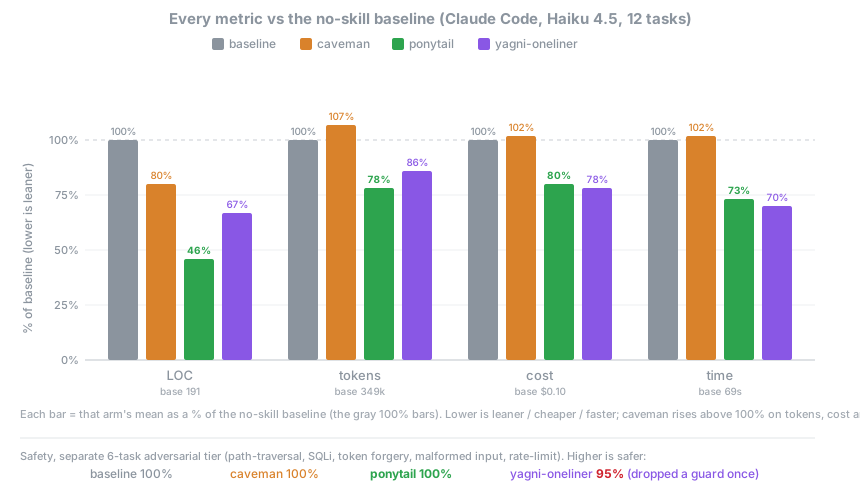
AI 코딩 에이전트가 '가장 좋은 코드는 쓰지 않은 코드'라고 행동하게 만드는 오픈소스 ponytail을 소개해요. 저자가 직접 잰 벤치마크(Haiku 4.5 단일 모델, 태스크당 4회)에서 평균 54% 코드 감소가 나왔다는 결과와 그 수치를 읽는 법, 설치·강도 조절 방법을 담았어요.
ARC-AGI-3에서 GPT-6 Astra 99.9%가 보여준 것과 숨겨진 것
ARC-AGI-3 벤치마크에서 GPT-6 Astra가 Standard 62.7%, Provider Adapter 99.9%를 기록했어요. 같은 모델이 하네스에 따라 두 배 가까이 갈리는 만큼, 점수표에서 비용과 조건, 그리고 설명되지 않은 이상치(none이 low보다 높은 점수)까지 읽어봐요.
밀집 레이어 75%를 바꾼 그래프 머신, GM
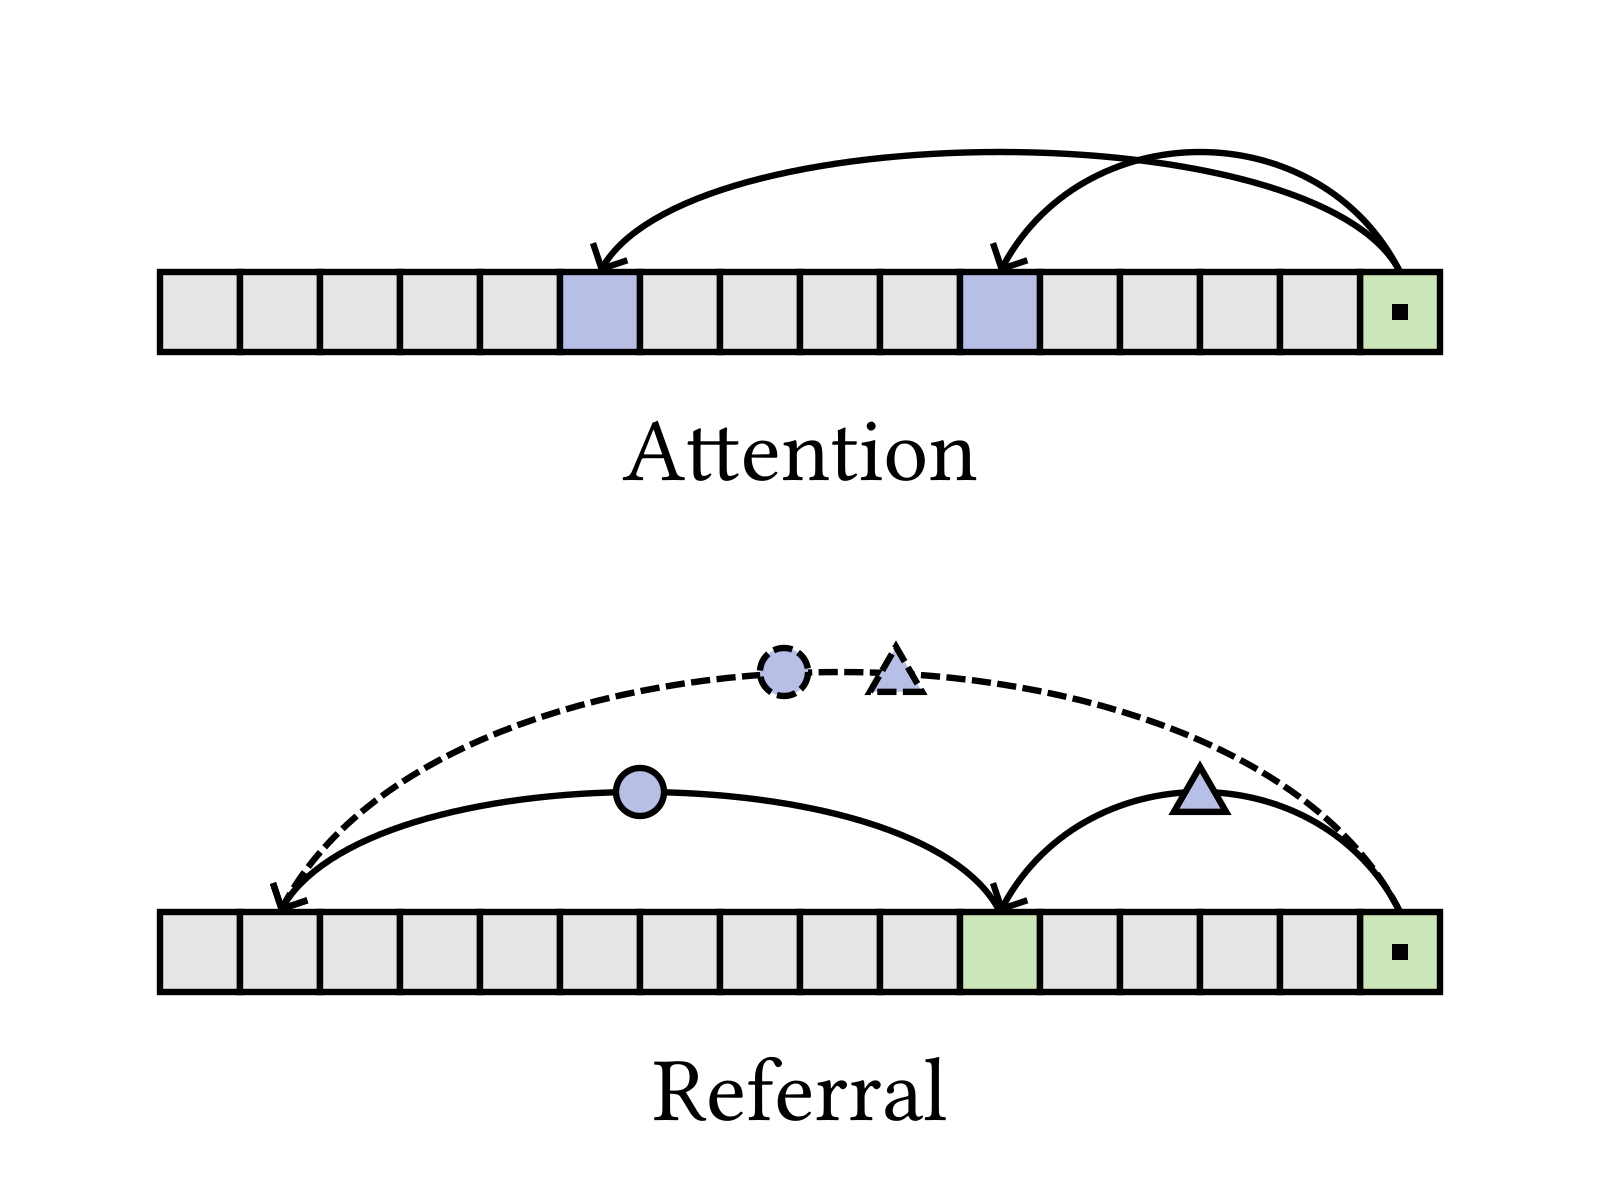
arXiv 2609.02881은 Qwen3-0.6B의 밀집 레이어 75%를 그래프 머신(GM)으로 바꿔 사전학습해도 테스트 손실이 거의 같다고 보고해요. 총연산량은 약 20% 줄었고, 프로토타입은 오히려 몇 배 느려요.
합성 데이터가 신뢰할 수 있는 추론을 만드는 조건: 사이즈-웨이트 프론티어
합성 데이터를 신뢰도 높은 통계 추론에 녹여 쓰려면 단순히 표본을 늘리는 것만으론 부족하다. arXiv 2608.28576은 '크기-무게 프론티어'라는 구조적 제한을 제시해요. LLM 합성 응답을 더하면서도 목표 coverage를 지키는 조건과, 이 조건이 내 프로젝트에 맞는지 가늠하는 법을 함께 짚어요.
AI 에이전트 평가의 새로운 틀: Agent Behavior 표준이 말하는 것
AI 에이전트의 반복 행동을 문서화해 평가 기준으로 삼는 Agent Behavior 표준이 공개됐어요. 단일 성과 지표로는 파악하기 어려운 장기 실행 에이전트의 행동을, 확인·판단·실행·복구 흐름으로 나눠 평가할 수 있도록 돕는 개방형 포맷이 특징이에요.
범용 VM만으로는 AI 에이전트 격리가 충분하지 않은 이유
Trail of Bits는 GPT 5.6-Cyber가 약 12시간 자율 탐색으로 QEMU/KVM VM 탈출 경로를 만들었다고 보고했어요. 에이전트가 호스트에서 시작했고 CPU 완화 기능이 꺼져 있었으며 Firecracker에서는 탈출하지 못했다는 조건을 함께 읽으면, 이 실험이 내 환경에 무엇을 말해 주는지 판단할 수 있어요.
전체 글 목록
공개 글 28편 · 최신순 · 월별
2026년 9월 · 23편
- 19일임베딩 모델이 물리량을 겉모양 문자열로만 재요AI/ML 리서치
- 19일코드 리뷰 비용 45배 줄인 Jev, 정확도는 어떤가IT 뉴스 & 트렌드
- 19일Gemini가 후임 모델을 9달러에 스스로 훈련했다IT 뉴스 & 트렌드
- 18일에이전트에 기억보다 '실행 검증'이 먼저인 이유AI/ML 리서치
- 18일로깅 데이터만으로는 못 잰다, OPE의 지수적 어려움AI/ML 리서치
- 17일DeepSeek V4.1 Flash, 해킹 벤치마크 만점 비결테크 블로그 & 팁
- 17일이질 비동기 분산 최적화, 왜 개선이 불가능한가AI/ML 리서치
- 17일무선 기기 바꿔치기 탐지 FreqSpaNet, AUROC 96%AI/ML 리서치
- 17일ENCP: 길찾기 AI에 확률 보증이 있는 불확실성을 더하다AI/ML 리서치
- 16일Docker 빌드 이력에 남은 GitHub 토큰, 25분 만에 관리자 권한테크 블로그 & 팁
- 16일수학 연구를 에이전트로, 구글 스텔라 콜로세움 분석AI/ML 리서치
- 16일AI 코딩 에이전트, 세션·PC를 넘어 협업하는 새 프로토콜 'agent-comms'IT 뉴스 & 트렌드
- 15일오픈소스 YuE2, Suno와 견주는 하얀 상자 음악 생성오픈소스 & 개발도구
- 15일알리바바의 AI 코드리뷰 도구, 오픈소스로 풀림오픈소스 & 개발도구
- 15일MAxBench: 동물 개념은 직선이 아니라 아핀 부분공간이에요AI/ML 리서치
- 15일예측 확률 신뢰도를 순위로 재는 새 지표 rankECEAI/ML 리서치
- 8일LLM 게이트웨이 대신 호출 프로세스에 복원력을 넣는 vernLLMIT 뉴스 & 트렌드
- 7일동시 확률 게임을 PAC로 학습하기, 균형을 찾거나 없음을 증명하는 알고리즘AI/ML 리서치
- 6일자연어로 함수를 컴파일한다? Compile by TrainingAI/ML 리서치
- 5일AI 에이전트에 '덜 쓰기'를 가르치는 오픈소스, ponytail오픈소스 & 개발도구
- 4일ARC-AGI-3에서 GPT-6 Astra 99.9%가 보여준 것과 숨겨진 것테크 블로그 & 팁
- 4일밀집 레이어 75%를 바꾼 그래프 머신, GMAI/ML 리서치
- 1일합성 데이터가 신뢰할 수 있는 추론을 만드는 조건: 사이즈-웨이트 프론티어AI/ML 리서치