자연어로 함수를 컴파일한다? Compile by Training
매 입력마다 대형 모델 API를 호출하는 대신, 한 번의 컴파일로 사양을 로컬 신경 함수로 바꾸는 'Compile by Training'을 소개해요. 벤치마크에서 의미 정확도 22.4%에서 83.6%로 올리고, 컴파일 후에는 교사 모델 없이도 동작해요.
매번 큰 모델을 부를 필요가 있을까요
반복되는 텍스트 함수 하나를 떠올려봐요. 이메일을 우선순위로 분류하면 "Signature needed by EOD" 같은 메일은 바로 처리해야 하고, 뉴스레터는 뒤로 미뤄야 해요. 이런 동작은 말로 설명하긴 쉬운데, 규칙 코드로 짜려면 너무 지저분해요. 그래서 우리는 대부분 거대 언어 모델(LLM)의 API로 해결하죠.
매번 큰 모델 API를 부르는 게 당연한 개발 환경에서, 반복되는 텍스트 함수 = 대형 원격 LLM 호출이라는 공식은 이제 의심해볼 때가 됐어요. 논문 한 편이 이 중간 지점을 정확히 노리는데요. 바로 워털루 대학의 Yuntian Deng, Pengyu Nie와 하버드 대학의 Stuart Shieber가 쓴 'Compile by Training: Turning Natural-Language Specifications into Local Neural Functions'(arXiv:2609.04199, EMNLP 2026 System Demonstrations)이에요.
컴파일을 훈련으로 대체해요
제안의 핵심은 '어댑테이션을 런타임 의존성이 아니라 빌드 단계로 바꾸자'는 거예요. 자연어로 함수 동작을 적어 두면, 편집 과정에서 교사 모델(teacher model)들이 그 사양의 예시를 생성하고, 그 예시로 작은 어댑터를 훈련해 컴팩트한 인터프리터에 최적화시켜요. 결과물은 교사 모델 없이도 돌아가는 로컬 신경 함수가 돼요.
기존: 모든 입력 x -> 대형 원격 LLM 호출 (매번 비용·지연·공급자 의존) 제안: 사양 s -> 컴파일(훈련) -> 프로그램 p_s -> 모든 입력 x -> 로컬 실행
이 시스템은 같은 팀의 앞선 연구 'Program-as-Weights'(PAW) 패러다임 위에 서 있어요. PAW는 여러 함수가 공유하는 고정 인터프리터를 두고, 함수마다 신경 프로그램으로 특화시키는 방식이에요. 기존 PAW의 고속 컴파일러는 단일 순방향 패스로 어댑터를 예측해 몇 초 만에 끝나지만, 모든 함수에 같은 계산량을 쓰는 단점이 있었어요. Compile by Training은 그 고속 예측을 출발점 삼아, 교사 합성과 함수별 최적화에 추가 계산을 들여 더 나은 프로그램을 만들어요.
어떻게 훈련하는지 볼게요
컴파일은 두 단계로 진행돼요. 먼저 교사 모델이 사양으로부터 작업별 예시 쌍을 합성해요. 요청은 구조화된 JSON 형식으로 보내고, 컴파일러는 반환값을 검증해서 잘못되거나 불완전한 배치를 걸러내고, 통과한 예시만 훈련 파이프라인에 넘겨줘요.
Gradient descent가 아주 작은 어댑터를 특화시키는데, 이때 인터프리터는 양자화된 Qwen3-0.6B 모델 하나를 모든 함수가 공유해요. 함수마다 배우는 건 rank-64 LoRA 어댑터와 런타임 스캐폴드(사양을 구조화된 지시·예시로 담은 프롬프트 템플릿)뿐이에요. 훈련이 끝나면 어댑터·스캐폴드·원래 사양·인터프리터 메타데이터를 하나의 프로그램 아티팩트로 묶어요. 그건 .paw 파일처럼 보관·버전관리·캐싱할 수 있고, 일반 소프트웨어처럼 재사용해요.
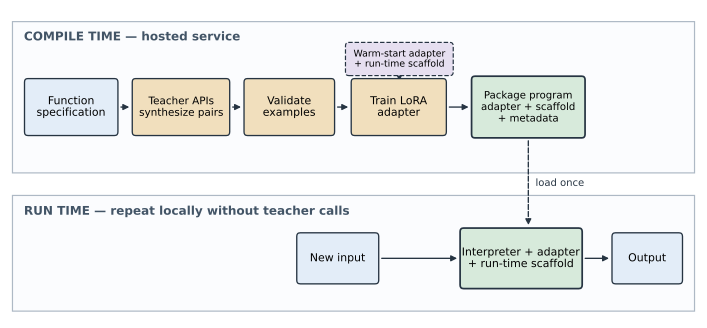 출처: arXiv:2609.04199 그림 2 — Compile by training
그림 출처: arXiv:2609.04199 그림 2 · Deng, Nie, Shieber · CC BY 4.0 · 원본 그대로 사용
컴파일은 호스팅 프로세스라 사양이 PAW 서비스와 교사 API로 보내져 지도 데이터와 훈련을 만들어요. 반면에 로컬 SDK 실행은 앞으로의 입력을 PAW나 교사에게 보내지 않아요. 컴파일 후 런타임은 SDK가 새 입력과 프로그램의 런타임 프롬프트·어댑터를 합쳐 공유 인터프리터로 처리할 뿐이에요.
정확성이 오르는 대가는 컴파일 시간
저자들은 FuzzyBench-Hard에서 평가했어요. PAW 고속 컴파일러가 정확히 일치를 하나도 내지 못했던 서브셋인데, Compile by Training은 의미 정확도 83.6%를 기록했어요. 정확도(LEM)는 22.4%에서 83.6%로 61.2%포인트 올랐고, 대신 컴파일 시간은 50.9초로 PAW의 3.5초보다 길어요.
정확도 비결은 데이터 규모에도 숨어있어요. GPT-5.4-mini 단일 교사일 때 평균 74.6%였던 LEM(LLM 판정관이 사양에 비춰 의미상 맞다고 본 비율)이, GPT-5.4-mini와 GPT-5.5를 2:1로 섞으면 85.1%까지 올라가요. 학습 예시 수도 1440쌍일 때 82.1%에서 7200쌍일 때 86.6%까지 오르지만, 2400쌍 이상부터는 수확 체감이 분명해요.
배포 시점의 지연 측정도 흥미로워요. 같은 사양을 B300에서 50.9초, H200에서 68.2초, RTX GPU에서 99.2초에 컴파일했어요. 4작업 동시에 넣는 부하 테스트에서는 평균 큐 대기 1.01초로 처리됐고, 교사 합성이 대부분의 시간을 잡아먹기 때문에 합성과 훈련을 겹치는 설계가 실제로 빠른 응답으로 이어진다고 설명해요.
진짜 응용 사례
논문은 세 가지 시연으로 실제 동작을 보여줘요. paw-helper라는 웹사이트 도우미에 30개의 컴파일된 프로그램을 넣어 라우팅했어요. 수업 질문이 들어오면 링크인지 답변인지 분류하고, 코스 페이지 답변과 Piazza 검색 결과를 합치는 파이프라인을 구성했어요.
Avatar Director에서는 자연어로 3D 아바타를 조종해요. "jump twice, then dance" 같은 지시를 자연어로 입력하면, 컴파일된 프로그램이 DSL로 번역해서 브라우저에서 애니메이션으로 보여줘요. 44개 검증 지시 중 43개에서 기대한 구조를 만들어냈어요.
또 영어와 Claudish를 양방향 번역하는 서비스예요. Claude Code와 관련된 표현 패턴을 영어로 번역하거나 그 반대를 할 수 있고, 두 방향 모두 작은 어댑터로 동작해요.
83.6%를 읽는 법
가장 큰 숫자부터 조건을 따져봐요. FuzzyBench-Hard는 PAW 고속 컴파일러가 정확히 일치를 하나도 못 낸 사양만 모은 부분집합이에요. 기존 방식이 가장 약한 곳을 골라 비교한 셈이라, 22.4%에서 83.6%로의 도약은 "모든 사양에서 이만큼 좋아진다"가 아니라 "고속 예측이 실패하던 어려운 사양에서 이만큼 회복한다"로 읽어야 해요. 논문은 이 부분집합의 전체 크기도 밝히지 않아요. 평가 지표인 LEM도 정확 일치가 아니라 LLM 판정관의 의미상 판정이라, 판정관의 기준이 점수에 섞여 있어요.
교사 구성 실험은 이 시스템의 천장을 보여줘요. 교사를 GPT-5.4-mini 하나에서 GPT-5.5를 섞은 조합으로 바꾸자 74.6%가 85.1%로 올랐고, 예시 수를 7,200쌍까지 늘려도 86.6%였어요. 반면 예시를 2,400~3,600쌍에서 83.6%였던 점을 보면 데이터를 더 쏟는 것보다 교사의 질이 더 크게 작용한 거예요. 논문도 한계로 "합성 감독은 교사의 오류를 물려받을 수 있다"고 밝히고, 정확성이 보장돼야 하는 응용에서는 출력을 검증하거나 결정적 경로를 남겨두라고 말해요. 컴파일된 함수는 교사가 모르는 규칙을 배울 수 없고, 사양이 모호하면 교사의 해석이 그대로 굳어져요.
이 방식이 맞는 경우와 맞지 않는 경우
컴파일 시간은 50.9초에서 99.2초까지(GPU에 따라) 걸리고, 사양을 바꿀 때마다 다시 거쳐야 해요. 사양이 자주 바뀌는 초기 탐색에서는 API 호출이 더 편해요. 반대로 사양이 고정되고 호출량이 많은 분류·라우팅·포맷 변환이라면 한 번의 컴파일 비용이 입력 수만큼 나뉘어요. 손익분기점은 호출 단가와 호출량에 달려 있어 논문이 계산해주지 않으니, 도입 전에 각자의 API 단가로 직접 따져봐야 해요.
비교 대상도 구분해야 해요. 이 방식은 논문이 인용하는 Prompt2Model(자연어 설명에서 작은 전용 모델을 만드는 선행 연구), LoRA Land 같은 합성 데이터 증류와 LoRA 계열의 연장선에 있어요. 새로운 점은 여러 함수가 하나의 양자화된 0.6B 인터프리터를 공유하고 함수마다 rank-64 어댑터와 스캐폴드만 .paw 아티팩트로 들고 다닌다는 배포 단위예요. 모델을 함수 수만큼 따로 두지 않아도 되므로, 작은 로컬 함수 수십 개를 관리하는 상황에서 이 구조가 유리해요. 한편 0.6B 인터프리터의 한계는 그대로 남아서, 긴 문맥을 추론하거나 사실 지식이 필요한 함수에는 맞지 않을 가능성이 커요(이 부분은 논문이 직접 검증한 범위가 아니에요).
정리하면
지금까지 함수를 '규칙'과 '대형 모델 호출' 사이에서 고른다면, Compile by Training은 '한 번 빌드해서 로컬에서 쓴다'는 제3의 선택지를 줘요. 특히 반복 호출이 많은 분류·라우팅·포맷 변환 같은 작업에서, 컴파일 시간과 교사 오류 상속을 감당할 수 있다면 실행 단계의 비용·지연·외부 의존을 줄일 수 있어요. 공개 인터랙티브 서비스(https://programasweights.com)와 소스(https://github.com/programasweights/paw-helper)도 함께 공개됐으니 직접 확인해볼 수 있어요.
참고 링크
관련 글
임베딩 모델이 물리량을 겉모양 문자열로만 재요
임베딩 모델 24종이 물리량(길이·질량·시간·부피) 사이의 관계를 얼마나 충실히 반영하는지 분석한 논문이에요. 결론은 전 모델이 물리적 거리를 제대로 못 재고, 수치 의미보다 겉모양 문자열 유사도에 크게 좌우된다는 것. 단위 변환도 흐릿하며, 크기·최신성·차원은 정렬도에 별 영향을 주지 못해요.
이질 비동기 분산 최적화, 왜 개선이 불가능한가
워커마다 다른 데이터 분포를 쓰는 이종 비동기 분산 학습은 동종 설정보다 훨씬 느린 시간복잡도에 묶여요. 2026년 9월 arXiv 논문은 이 격차가 흔한 함수 유사성 가정으론 수학적으로 좁힐 수 없음을 증명하고, 강한 보간과 국소 Polyak-Łojasiewicz 조건을 함께 요구할 때만 동종 수준의 수렴 보장이 가능함을 보여줘요.
무선 기기 바꿔치기 탐지 FreqSpaNet, AUROC 96%
하드웨어를 몰래 교체해도 논리적 정체성은 유지되는 무선 기기의 위협을 다룬 연구예요. FreqSpaNet은 주파수·방향 정보를 각각 학습해 평균 AUROC 96.31%를 기록했지만, 실험은 한 곳·한 수신기 조건이라 일반화 범위를 함께 짚어요.
공개 자료를 바탕으로 AI가 쓰고, 발행 전에 수치와 주장을 원문과 대조합니다.