합성 데이터가 신뢰할 수 있는 추론을 만드는 조건: 사이즈-웨이트 프론티어
합성 데이터를 신뢰도 높은 통계 추론에 녹여 쓰려면 단순히 표본을 늘리는 것만으론 부족하다. arXiv 2608.28576은 '크기-무게 프론티어'라는 구조적 제한을 제시해요. LLM 합성 응답을 더하면서도 목표 coverage를 지키는 조건과, 이 조건이 내 프로젝트에 맞는지 가늠하는 법을 함께 짚어요.
합성 데이터, 왜 지금인가
LLM으로 만든 응답이 설문·사용자 연구·실험 보조 자료로 쓰이면서, "얼마나 더 써도 되는가"가 실제 통계 추론에서 중요한 문제로 떠올랐어요. 단순히 합성 표본을 많이 넣으면 분산이 줄어들어 좋아 보이지만, 합성 분포가 실제 모집단과 어긋날 때 신뢰구간은 오히려 믿을 수 없게 좁아져요. 이 논문은 그 지점을 수학적으로 분리해 크기-무게 프론티어라는 개념으로 정리해요.
배경: 합성 데이터와 편향의 교차점
실제 데이터가 적을 때 합성 데이터로 보충하는 시도는 오래됐어요. 최근에는 LLM이 저비용으로 대량의 응답을 생성할 수 있게 돼, 설문 보충이나 cold-start 추천 같은 곳에 실제로 활용되고 있죠. 문제는 합성 데이터가 실제 분포와 체계적으로 다를 수 있다는 점이에요. 이를 그냥 실제 표본처럼 취급하면, 추정치는 안정적으로 보여도 실제 모수(target parameter)를 놓칠 수 있어요. 즉, 넓이와 신뢰도는 분리해서 봐야 하는 과제가 생기는 거예요.
핵심 개념: 프론티어, 그리고 두 가지 보정 방법
논문은 합성 데이터를 세 가지 요소로 쪼개요: 실제 표본 수 n, 합성 표본 수 k, 합성 표본의 가중치 lambda. 여기서 가중치는 "실제 표본 하나의 무게를 1이라고 할 때, 합성 표본 한 개는 얼마나 센가"를 의미해요.
연구진은 각 lambda에 대해, "모든 k가 목표 coverage를 만족하는 최대 k"를 경계로 정의해요. 이를 oracle size-weight frontier라고 부르죠. 이 경계 아래에 있는 (lambda, k) 쌍만이 안전한 합성 보충 구간이라는 뜻이에요.
문제는 실제 연구에서는 이 경계를 미리 알 수 없다는 점이죠. 그래서 연구진은 역사적 과제 데이터를 활용해 경계를 추정하는 알고리즘을 제시해요. 경계를 추정할 때 쓰는 기준 집합(proxy)을 만드는 방식으로 두 가지를 제안해요.
- full-sample proxy: 실제 데이터를 모두 써서 기준 집합을 만들고, marginal 수준의 유효성(논문 표기로 1−γα)을 요구해요.
- split-sample proxy: 따로 떼어 둔 실제 데이터로 독립적인 기준 집합을 만들고, 더 강한 task-conditional 유효성(1−γ)을 요구해요.
논문은 full-sample 쪽이 덜 보수적이고, split-sample 쪽이 더 엄격한 대신 데이터 효율을 희생한다고 설명해요.
정리된 보증: 프론티어 아래라면 안전하다
추정된 프론티어 k^는 경계 아래 모든 (lambda, k)에 대해 유사한 샘플 크기에서 coverage 보증을 동시에 만족해요. 정확히 말하면, 높은 확률로 목표 coverage에서 벗어나는 폭이 보정(calibration) 과제 수 J에 대해 J^(-1/2) 속도로 줄어드는 형태의 보증이에요.
여기서 중요한 점은 프론티어를 학습한 뒤 그 안에서 다시 구간 폭을 최소화하는 (lambda, k)를 선택해도 추가적인 보증 손실이 없다는 점이에요. 이론적으로 일관된 선택-후-검증 구간이 가능하다는 뜻이죠.
실험: LLM 응답으로 여론조사 보충하기
연구진은 WorldValuesBench 데이터로 실험했어요. 235개 설문 문항, 약 9만 6천 명(96,200명)의 응답자 데이터에서 신규 문항의 cold-start 상황을 흉내 내어 실제 표본 n을 10·30·50으로 두었고, GPT-4o와 GPT-5 mini를 합성 시뮬레이터로 사용했죠.
논문에 따르면 두 LLM, 두 proxy, 모든 n에서 coverage가 목표 수준 0.9 위에 머물렀어요. 신뢰구간 폭은 n=10, 30에서 대략 4253%, n=50에서 대략 3444% 줄었다고 해요. 특히 weight를 낮춰 합성 표본의 개별 영향력을 제한하면서도, 프론티어가 허용하는 범위에서 합성 정보를 최대한 녹이는 전략이 실제로 작동했어요.
왜 중요한가
기존 합성 데이터 연구가 "쓰면 좋다" 또는 "위험하다"는 식으로 이분법적으로 말하는 경우가 많았어요. 이 논문은 그 사이의 회색 영역을 구체적인 조건으로 바꿔줘요. 실제 서베이나 cold-start UX 연구처럼 실제 표본이 적은 상황에서도, 프론티어 안에서 합성 표본의 수와 가중치를 조절하면 데이터 효율을 높이면서도 추론 왜곡을 줄일 수 있다는 게 핵심이에요.
한편 이 결과는 LLM 합성 응답을 보조 자료로 쓰는 현재 흐름에서도 바로 적용할 수 있어요. 가중치를 너무 높이면 합성 데이터가 실제 분포를 밀어내고, coverage 보증이 깨지는 상황을 수학적으로 피할 수 있게 된 거죠.
실무에서 쓰려면 무엇이 필요한가
이 방법의 전제부터 확인해야 해요. 프론티어는 과거의 관련 과제 여러 개에서 학습해요. 논문 초록도 여러 관련 과제의 이력 데이터가 있어야 한다는 점을 전제로 밝혀요. 그러니 같은 형식의 설문을 여러 번 해 본 팀이라면 써 볼 만하지만, 처음 하는 설문이거나 이전 과제와 성격이 다르다면 프론티어를 추정할 재료가 없어요. 이건 "합성 데이터를 얼마나 섞어도 되는가"라는 질문에 숫자로 답하는 대신, 과거 데이터로 답을 학습해 두라는 접근이에요.
두 번째는 보증의 성격이에요. 이 방법이 지켜 주는 건 신뢰구간이 목표 비율만큼 참값을 덮는 coverage이고, 구간이 얼마나 좁아지는지는 합성 데이터의 질에 달려 있어요. 합성 응답이 실제와 크게 어긋나면 프론티어 안의 허용 크기 k가 작아져서 결국 합성 데이터를 거의 못 쓰게 돼요. 반대로 합성이 꽤 좋은 영역에서는 더 많이 섞을 수 있어요. 가중치 lambda를 낮추면 안전해지지만 얻는 정보도 줄어요. 이 trade-off를 사후에 눈대중으로 정하지 않고 데이터로 정하는 것이 이 논문의 기여로 읽혀요.
세 번째는 입력 모델이 바뀌는 문제예요. 실험은 GPT-4o와 GPT-5 mini로 했어요. 같은 문항이라도 합성기를 다른 모델이나 프롬프트로 바꾸면 합성 분포가 달라져서 이미 학습한 프론티어를 그대로 쓸 수 없을 가능성이 커요. 이건 논문이 직접 검증한 내용이 아니라 프론티어가 합성기별로 학습된다는 정의에서 제가 끌어낸 주의점이에요. 합성기를 바꿀 때마다 과거 과제로 다시 보정한다고 생각하는 게 안전해요.
시사점과 한계
논문이 밝힌 한계는 보증이 task-conditional이 아니라 marginal 수준이라는 점, 그리고 보정 과제와 실제 적용 과제가 같은 분포에서 독립적으로 뽑혔다고 가정한다는 점이에요. 가중치 격자도 미리 정해 두어야 해요. 실험도 GPT-4o와 GPT-5 mini, 설문 데이터 한 종류에 한정돼서, 다른 모델이나 도메인에서 같은 결과가 나오는지는 이 논문만으로는 알 수 없어요.
저자들은 분포 변화에도 견디는 shift-aware 또는 covariate-conditional 프론티어를 향후 과제로 제시해요. 그래도 합성 데이터를 안전하게 쓸 수 있는 최소한의 틀을 제공한 점에서 이 논문의 실용적 의미는 충분해요.
참고 링크
- arXiv 원문: Learning a Size-Weight Frontier for Synthetic-Augmented Inference
- arXiv PDF: 2608.28576.pdf
관련 글
이질 비동기 분산 최적화, 왜 개선이 불가능한가
워커마다 다른 데이터 분포를 쓰는 이종 비동기 분산 학습은 동종 설정보다 훨씬 느린 시간복잡도에 묶여요. 2026년 9월 arXiv 논문은 이 격차가 흔한 함수 유사성 가정으론 수학적으로 좁힐 수 없음을 증명하고, 강한 보간과 국소 Polyak-Łojasiewicz 조건을 함께 요구할 때만 동종 수준의 수렴 보장이 가능함을 보여줘요.
ENCP: 길찾기 AI에 확률 보증이 있는 불확실성을 더하다
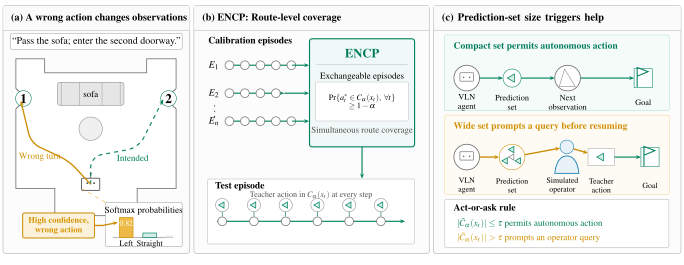
길찾기 AI(VLN)는 한 걸음 잘못 디디면 뒤로 계속 틀려가는 오류 누적에 취약한데, 새 논문 ENCP는 여기에 확률 보증이 있는 불확실성 추정을 제안해요. 에피소드마다 최댓값 하나만 캘리브레이션해 경로 전체의 커버리지를 보장했고, 실험에서 스텝 커버리지 목표를 모두 달성했으며, 예측 집합 크기로 사람에게 도움을 요청할 시점을 정합니다.
LLM 게이트웨이 대신 호출 프로세스에 복원력을 넣는 vernLLM
Show HN에 오른 vernLLM은 게이트웨이를 거치지 않고 호출 프로세스 안에 rate-limit, 회로차단기, 폴백을 넣는 TypeScript 라이브러리예요. 게이트웨이와 비교해 무엇을 얻고 무엇을 직접 떠안는지, 여러 인스턴스로 돌릴 때 어떤 문제가 생기는지 짚어요.
공개 자료를 바탕으로 AI가 쓰고, 발행 전에 수치와 주장을 원문과 대조합니다.