밀집 레이어 75%를 바꾼 그래프 머신, GM
arXiv 2609.02881은 Qwen3-0.6B의 밀집 레이어 75%를 그래프 머신(GM)으로 바꿔 사전학습해도 테스트 손실이 거의 같다고 보고해요. 총연산량은 약 20% 줄었고, 프로토타입은 오히려 몇 배 느려요.
왜 지금 그래프 구조인가
Transformer는 key·value에 Θ(n) 크기의 상태를 유지하지만, 각 토큰이 전체 상태에 접근하면서 계산량이 Θ(n²)로 불어나요. 슬라이딩 윈도우 같은 방법은 접근 범위를 Θ(1)로 줄이지만, 접근 위치가 입력 내용과 무관하게 고정돼 필요한 정보를 놓치기 쉬워요. 이 논문은 그 중간 지점을 찾아요. 상태는 O(n) 크기로 유지하면서, 필요한 부분만 동적으로 골라 접근하는 방식이에요.
핵심 아이디어는 엣지를 포인터처럼 쓰는 거예요. GM(Graph Machine)은 두 가지 새로운 서브모듈, SER(Sparse Edge Referral)와 SEA(Sparse Edge Attention)를 도입해요. 여기서 엣지는 정수형 인덱스와 실수형 가중치를 함께 가지는데, 인덱스는 어디를 볼지 가리키고 가중치는 그 경로의 중요도를 표현해요. referral 메커니즘은 현재 이웃의 이웃을 참조하는 방식으로 엣지를 갱신하고, attention은 이 엣지가 가리키는 소수 위치의 키·값만 읽어들여요.
기존 attention과의 결정적 차이
논문은 시퀀스 모델을 상태 크기, 접근 크기, 동적 주소 비트 세 가지 기준으로 분류해요. RNN/SSM는 상태와 접근이 모두 Θ(1)이라 과거를 압축해야 하고, vanilla Transformer는 상태는 Θ(n)이지만 접근도 Θ(n)이라 계산이 비싸요. 슬라이딩 윈도우 Transformer는 상태는 Θ(n)인데 접근이 Θ(1)이지만 주소가 정적이에요. GM은 상태 Θ(n), 접근 Θ(1), 동적 주소 Θ(log n)을 만족하는 네 번째 범주에 속해요. 4,096 토큰 길이에서 2개나 4개의 위치만 읽는 게 dense causal attention이 쿼리당 평균 읽는 2,048.5개 위치의 0.098%, 0.195%라고 논문이 정의해요.
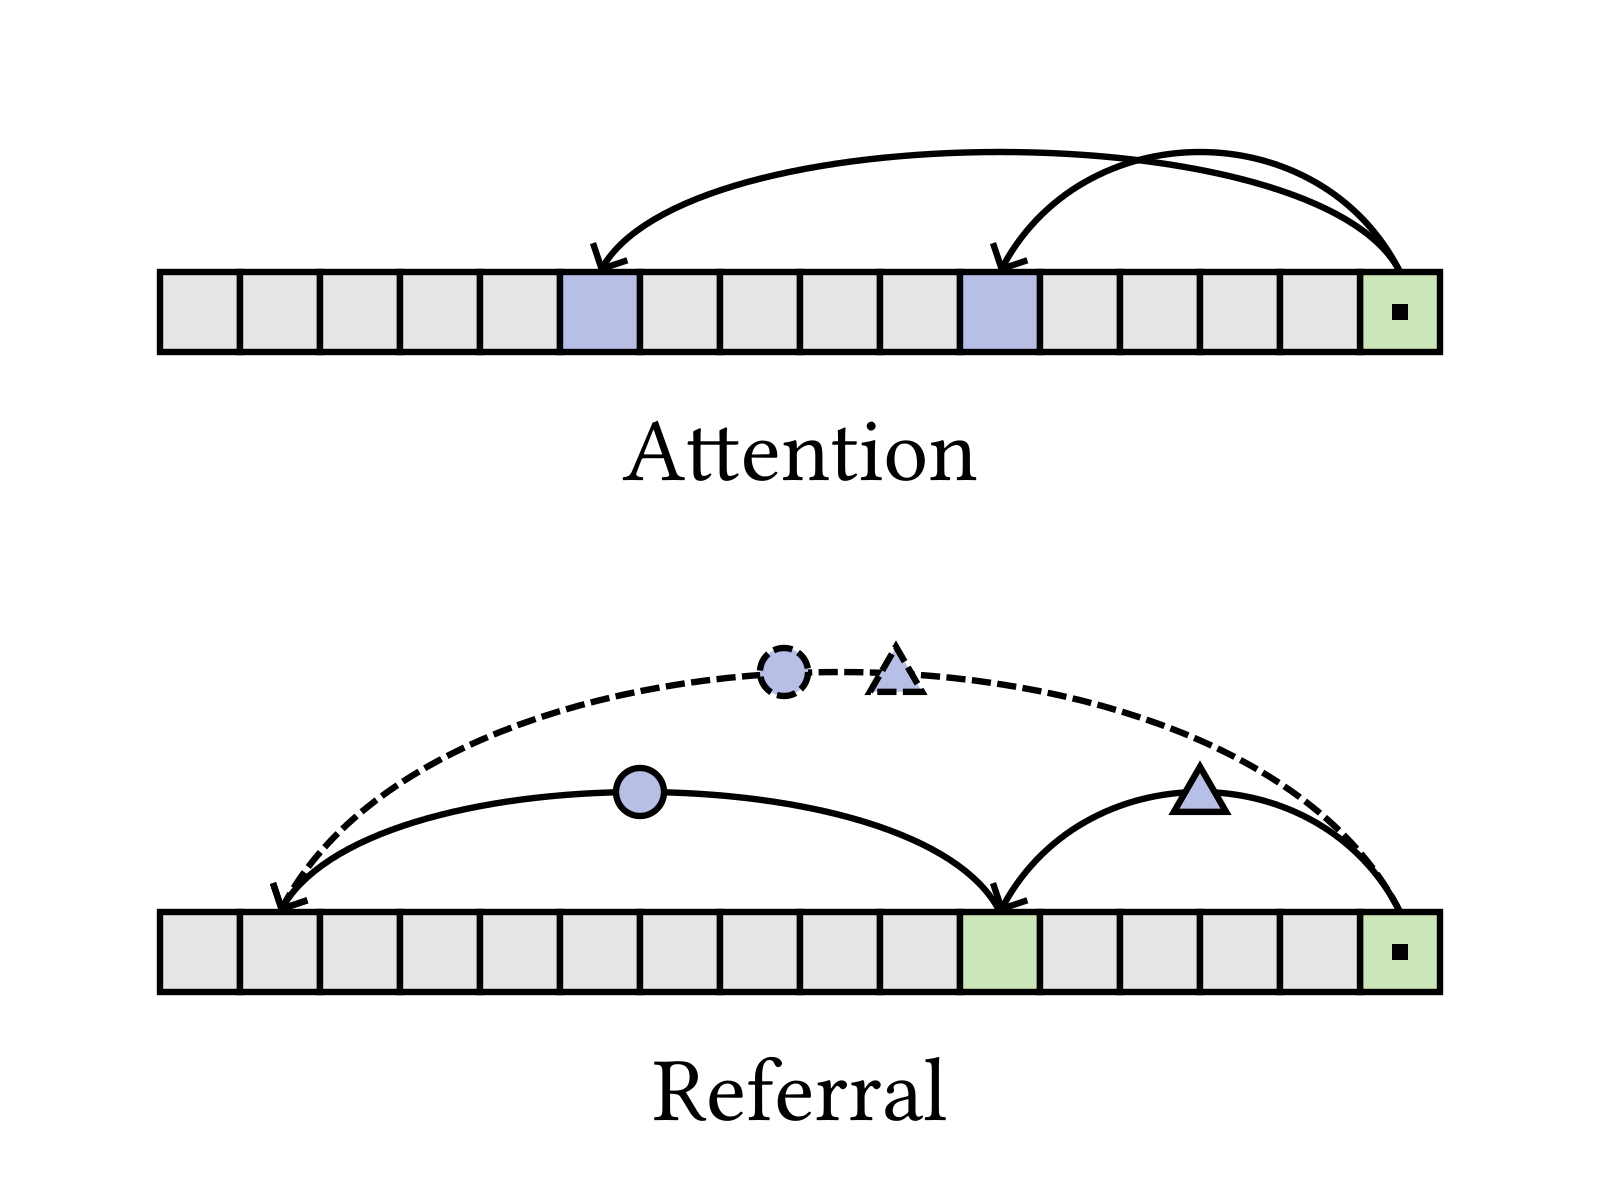 출처: arXiv:2609.02881 Figure 1
그림 출처: arXiv:2609.02881 그림 1 · Hou · CC BY 4.0 · 원본 그대로 사용
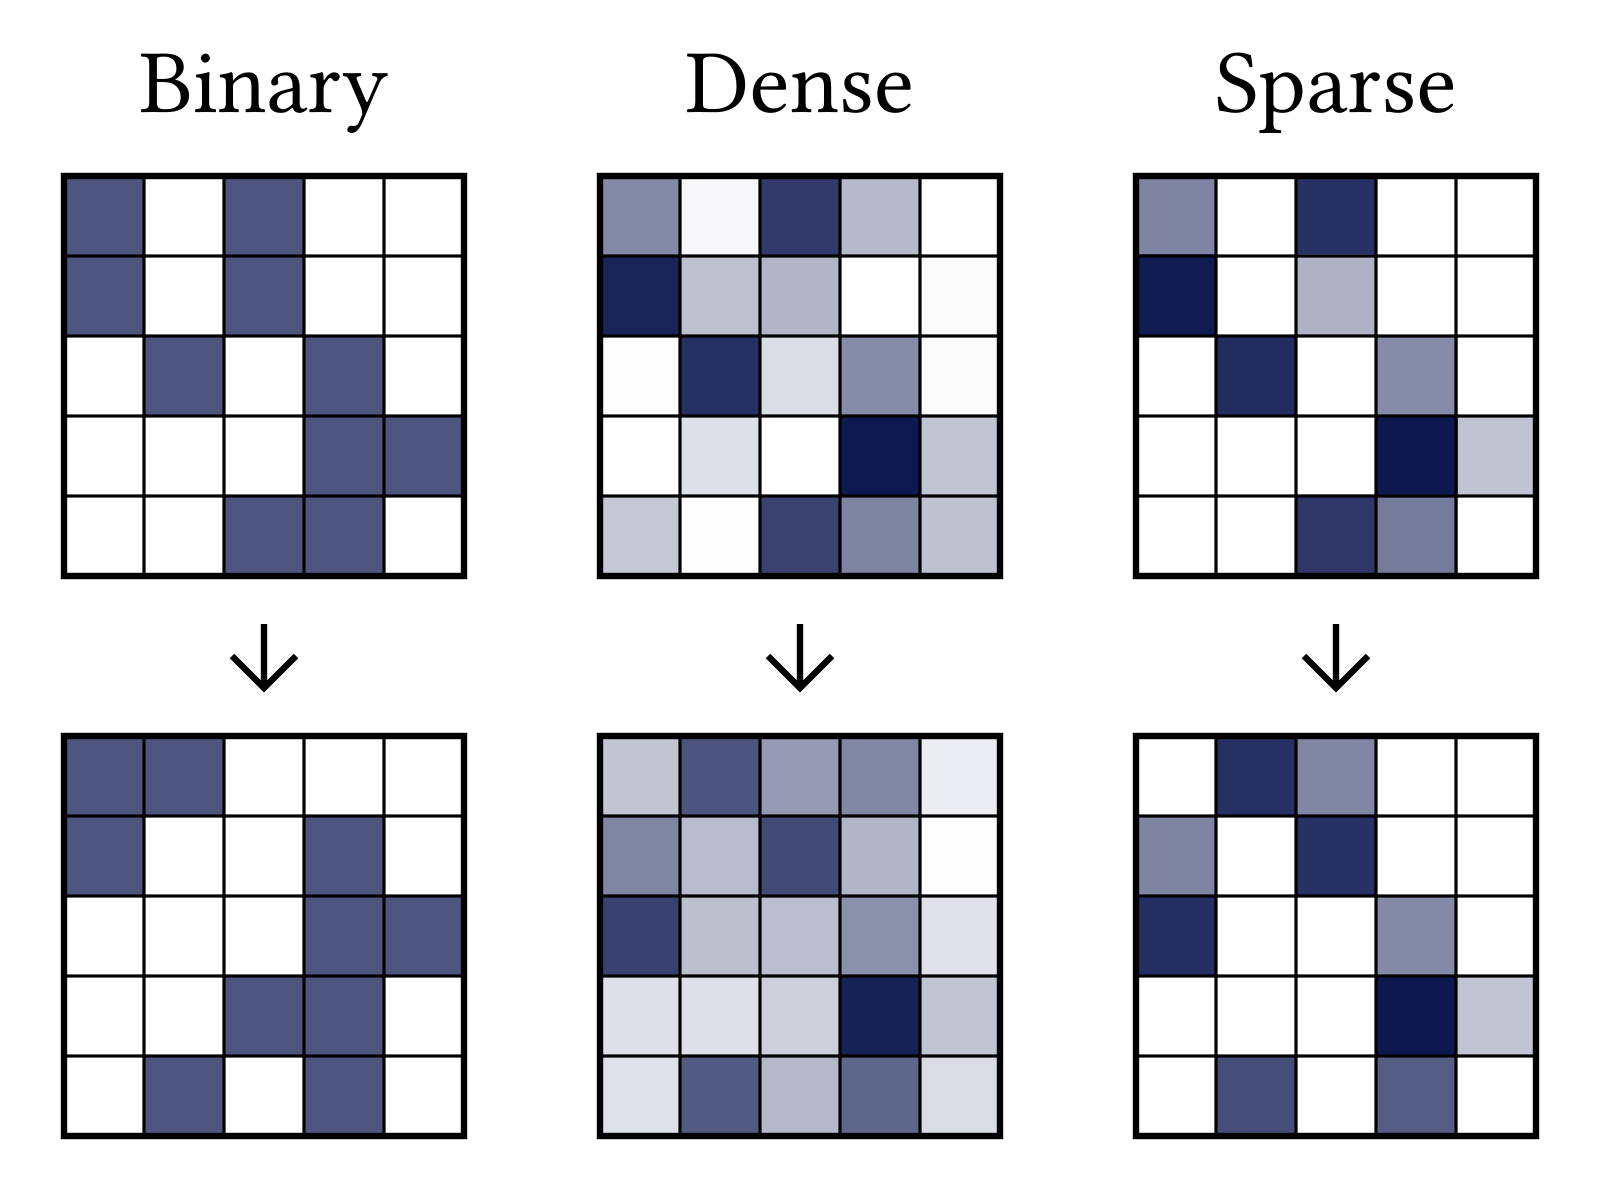 출처: arXiv:2609.02881 Figure 2
그림 출처: arXiv:2609.02881 그림 2 · Hou · CC BY 4.0 · 원본 그대로 사용
구조는 어떻게 생겼나
GM의 상태는 노드 특징(node features)과 엣지 인덱스(edge indices), 엣지 가중치(edge weights)로 구성돼요. 각 토큰은 초기 엣지로 자신과 바로 앞 k-1개 토큰을 가리키고, 레이어를 거치면서 referral로 엣지가 재구성돼요. 희소 레이어는 edge-referral 서브모듈과 edge-attention 서브모듈, MLP 순서로 반복되며, 밀집 레이어와 혼합된 GLM(Graph Language Machine)으로 훈련돼요.
referral은 ℓ-hop 이웃을 한 번에 구성하는 operation으로, 인접 행렬 Aℓ을 희소 행렬로 근사하는 과정과 같아요. attention 단계에서는 query·key 스코어와 엣지 가중치를 로짓 공간에서 더해 softmax를 적용하는 product-of-experts 방식으로 최종 가중치를 만들어요. 흥미롭게도, sparse attention 이후에 사용된 인덱스와 가중치를 저장된 엣지 중 일부에 다시 쓰는 realignment 옵션이 있어, attention이 본 feature evidence로 pointer 분포를 보정하는 루프가 생겨요.
실제 훈련 결과
실험은 Qwen3-0.6B를 기반으로 밀집 Transformer 레이어 75%를 GM 희소 레이어로 교체해 처음부터 15.7B 토큰 규모로 pretraining해요. 모델 이름은 sparsity budget, 저장 엣지 수, referral 스텝 수, dense-refresh 사용 여부로 구분해요. Theia 계열은 (2,4,4,2) budget으로 KV 헤드당 2개 위치를, Hyperion은 (4,4,4,4)로 4개 위치를 읽어요.
| 모델 | 파라미터 | 총 연산량 | referral+attention 연산량 | KV 접근 비중 |
|---|---|---|---|---|
| Qwen3 | 596M | 78.4 EFLOPs | 38.8 EFLOPs | 100.000% |
| Theia-K24 | 601M | 62.3 EFLOPs | 22.7 EFLOPs | 0.098% |
| Hyperion-K16-R3-S | 664M | 71.1 EFLOPs | 31.4 EFLOPs | 0.195% |
훈련은 H100 SXM 한 장에서 53236시간, 대부분 GLM 설정은 150160시간 구간에 몰렸어요. 테스트 손실 기준으로 Qwen3는 100% 훈련 시점에 2.587이고, Theia 최상은 +0.014, Hyperion 최상은 -0.003이에요. 특히 dense-refresh를 쓴 Hyperion-K16-R3-S가 전체 최저 손실을 기록했어요. referral 스텝이 0에서 3으로 늘어날 때 성능 개선이 뚜렷하지만, 더 늘리면 항상 좋아지지는 않아요. 또한 파라미터 수나 총 연산량이 성능의 강한 예측 변수가 아니다는 점도 흥미로워요. Hyperion-K16-R3-S는 상대적으로 저렴하면서도 최고 성능을 냈으니까요.
실제로 쓸 수 있을까
현재 프로토타입 구현 기준으로 GLM은 Qwen3보다 같은 하드웨어에서 여러 배 느려요. RTX 4090에서 일부 설정이 Qwen3 훈련 처리량에 근접하는 결과가 나와, 실제 성능 비율은 커널 구현과 하드웨어에 크게 의존한다는 점이 시사돼요. 또, 논문에서 제시한 실험은 0.6B 규모의 언어 모델 pretraining과 test loss 하나만 보는 수준이에요. 다운스트림 과제, 더 큰 스케일, 다른 아키텍처와의 결합 등은 앞으로 남은 작업이에요.
숫자를 다시 읽으면
제목에 "절반"을 쓰기 쉬운 결과지만 표는 그렇게 말하지 않아요. Qwen3 78.4 EFLOPs 대비 Theia-K24는 62.3 EFLOPs로 약 20%, Hyperion-K16-R3-S는 71.1 EFLOPs로 약 9% 줄어요. referral과 attention 부분만 보면 38.8에서 22.7 EFLOPs로 약 41% 줄었는데, 총연산량이 덜 줄어든 건 밀집 레이어 25%와 MLP 같은 다른 구성요소의 비용이 그대로 남기 때문이에요. 이건 표의 숫자에서 제가 계산한 해석이에요. 포인터 접근을 아무리 희소하게 만들어도 전체 연산에서 attention이 차지하는 비중이 상한을 정해요.
더 중요한 건 FLOPs와 실제 시간이 다르다는 점이에요. 논문은 현재 프로토타입에서 GLM이 같은 하드웨어의 Qwen3보다 대체로 몇 배 느리다고 인정해요. 희소 포인터 접근은 연산 수는 줄여도 메모리를 불규칙하게 읽어서 GPU의 연속 접근 이점을 잃기 쉽기 때문이라고 짐작되지만, 이건 제 추정이고 논문이 원인을 분해해 보이진 않아요.
비교 대상도 따져 봐야 해요. 같은 포인트를 슬라이딩 윈도우나 기존 희소 attention과 직접 놓고 본 실험은 이 글에서 확인하지 못했고, 위에 소개한 분류표는 논문의 개념 비교예요. 또 시퀀스 길이가 4,096이라서 논문도 지적하듯 문서 안에서 실제로 쓰는 문맥이 4,096에 못 미칠 수 있어요. GM이 진짜로 이점을 낼 영역인 긴 문맥에서는 아직 검증이 없어요.
마치며
GM이 보여준 가장 명확한 결과는 하나예요. 0.6B 모델 사전학습, 테스트 손실 기준으로는 dense attention을 거의 쓰지 않아도 품질이 크게 깎이지 않아요. 다운스트림 과제와 더 큰 모델에서의 확인은 논문이 미래 과제로 남겼어요. 상태는 O(n)으로 유지하면서 필요한 것만 읽는 이 구조가 실제 시스템에서 효율로 이어질지는, 커널과 하드웨어가 따라와야 알 수 있어요.
참고 링크
관련 글
임베딩 모델이 물리량을 겉모양 문자열로만 재요
임베딩 모델 24종이 물리량(길이·질량·시간·부피) 사이의 관계를 얼마나 충실히 반영하는지 분석한 논문이에요. 결론은 전 모델이 물리적 거리를 제대로 못 재고, 수치 의미보다 겉모양 문자열 유사도에 크게 좌우된다는 것. 단위 변환도 흐릿하며, 크기·최신성·차원은 정렬도에 별 영향을 주지 못해요.
에이전트에 기억보다 '실행 검증'이 먼저인 이유
듀얼프로세스 에이전트에 기억(AMM)과 자기 반성(SRM) 모듈을 붙이고 ScienceWorld에서 소거 실험한 arXiv 논문을 풀이했어요. 핵심은 기억이 아니라 실행 시점 제어가 성능 병목이며, 무한 반성이 오히려 해롭다는 점입니다.
로깅 데이터만으로는 못 잰다, OPE의 지수적 어려움
오프 정책 평가(OPE)가 부분 관측 환경 아래에서, 겉보기엔 건강한 로깅 데이터로도 지수적으로 어려워질 수 있음을 이론·실험으로 증명한 2026년 9월 arXiv 논문을 정리했어요. 필요 샘플이 (3/2)^H로 폭발하는 하한과 실무 시사점을 담았어요.
공개 자료를 바탕으로 AI가 쓰고, 발행 전에 수치와 주장을 원문과 대조합니다.